Vous ouvrez une plateforme pour chercher un film, un produit ou une vidéo. Avant même d’avoir formulé votre choix, une sélection vous attend déjà. Netflix met en avant une série, Spotify lance une playlist et une boutique en ligne suggère l’accessoire qui semble manquer à votre panier. Derrière ces propositions, il n’y a pas de lecture de pensée : il y a des données, des calculs et des arbitrages.
Un algorithme de recommandation estime ce qui pourrait vous intéresser à partir de vos actions et de celles d’autres utilisateurs. Il classe des options parmi un catalogue parfois immense, puis observe votre réaction pour ajuster la suite. Ce fonctionnement aide à trouver plus vite un contenu utile, mais il influence aussi ce qui devient visible. Comprendre ses mécanismes permet de mieux interpréter les suggestions, et de concevoir des expériences numériques plus pertinentes.
En bref
- Un moteur de recommandation transforme les clics, les vues, les achats et d’autres signaux en prédictions.
- Le filtrage collaboratif, l’approche par contenu et les systèmes hybrides sont les grandes familles de méthodes.
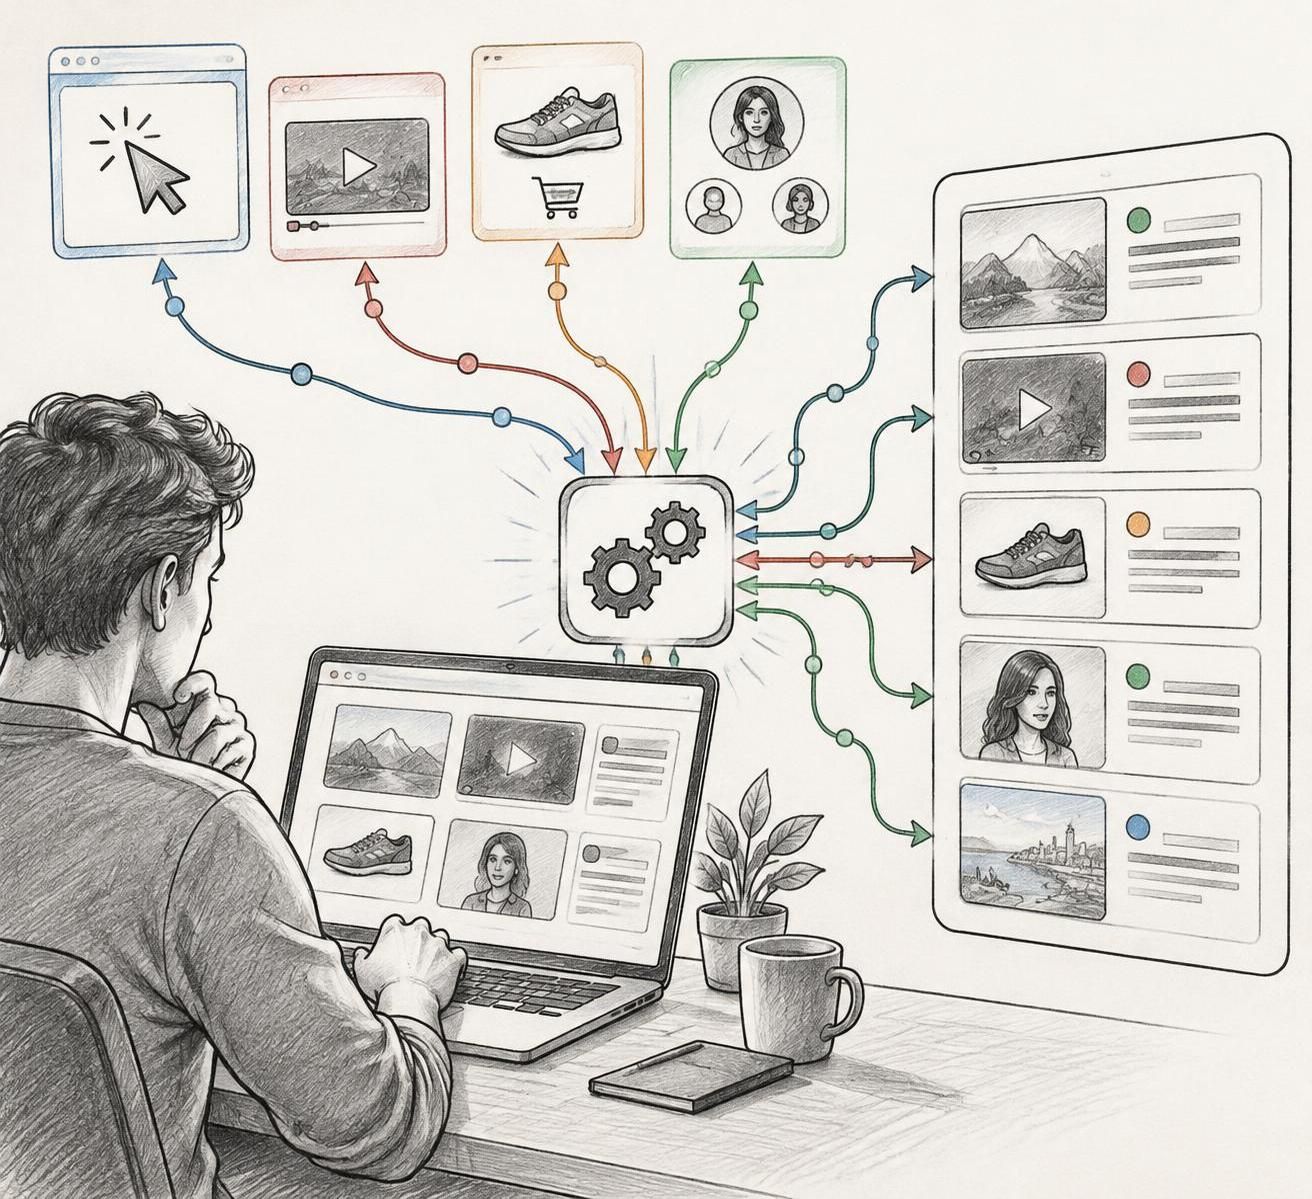
- Les moteurs modernes sélectionnent des candidats, les classent, puis ajustent l’ordre selon des objectifs et des règles.
- La personnalisation peut faire gagner du temps, mais aussi réduire la diversité ou amplifier certains biais.
- Un projet professionnel commence par un objectif mesurable, des données propres et des tests réguliers.
Comment un algorithme de recommandation transforme vos actions en suggestions
Une recommandation est une prédiction, pas une certitude. Le système estime qu’un contenu, un produit ou un service a de bonnes chances de vous convenir, puis le place plus ou moins haut dans une liste. Pour cela, il observe des interactions : une recherche, un clic, une lecture complète, un achat ou un abandon de panier.
Ces indices n’ont pas tous la même valeur. Une note ou un « j’aime » exprime clairement une préférence, mais beaucoup d’utilisateurs ne prennent pas le temps de donner leur avis. Les données implicites, comme la durée de visionnage ou le fait de revenir sur une page, sont disponibles en plus grande quantité. Elles doivent toutefois être interprétées avec prudence : regarder une vidéo jusqu’au bout ne signifie pas toujours l’avoir appréciée.
Des signaux explicites, implicites et contextuels
Le moteur peut aussi tenir compte du contexte : appareil utilisé, langue, moment de la journée ou contenu consulté juste avant. Une personne qui cherche une recette depuis son téléphone n’a pas nécessairement la même intention que lorsqu’elle compare un équipement de cuisine sur ordinateur. Le contexte affine la prédiction, sans révéler à lui seul les motivations réelles.
Imaginons une petite boutique en ligne, Atelier Nord, qui vend du matériel de randonnée. Un visiteur consulte plusieurs sacs légers, compare leur capacité et ajoute une gourde au panier. Ces gestes suggèrent un intérêt pour la randonnée, mais aussi une intention d’achat plus concrète qu’un simple passage sur la page d’accueil.
De la collecte au classement
Le système rassemble d’abord les événements autorisés, puis construit une représentation des goûts ou des besoins probables. Cette représentation peut être un profil comportant des catégories, ou un vecteur numérique utilisé pour comparer personnes et contenus. Il calcule ensuite un score d’affinité pour les options disponibles et affiche les mieux classées.
Un score élevé ne garantit pas qu’un élément sera présenté. Une boutique peut écarter un produit en rupture de stock ou mettre en avant une nouveauté. Une plateforme vidéo peut aussi varier les propositions afin d’éviter une page composée de contenus presque identiques. Le classement final reflète donc à la fois une estimation de pertinence et des choix de conception.
Pour Atelier Nord, recommander une housse compatible avec le sac consulté peut être utile ; pousser un produit indisponible ne l’est pas. Les données gagnent en valeur quand elles répondent à une question claire. Pour replacer cette logique parmi d’autres mécanismes automatisés, les exemples d’algorithmes appliqués au quotidien donnent des repères accessibles.
À retenir : le moteur ne connaît pas vos goûts, il formule une hypothèse à partir de traces d’usage qu’il faut interpréter.
Filtrage collaboratif, contenu et systèmes hybrides : trois logiques différentes
Il n’existe pas une seule méthode universelle pour recommander. Le choix dépend du catalogue, du volume de données et du résultat attendu. Une plateforme qui dispose d’un historique riche peut comparer les comportements ; un nouveau site, lui, doit souvent commencer par décrire ses contenus et ses produits.
| Approche | Principe | Atout | Limite |
|---|---|---|---|
| Filtrage collaboratif | Comparer les interactions de personnes ou d’objets proches | Peut faire découvrir des options inattendues | Difficile sans historique |
| Basée sur le contenu | Proposer des éléments aux caractéristiques similaires | Fonctionne même avec peu d’utilisateurs | Peut répéter les mêmes thèmes |
| Hybride | Combiner plusieurs signaux et méthodes | Plus robuste dans des situations variées | Demande plus de réglages |
Le filtrage collaboratif apprend des comportements collectifs
La logique est simple : si des utilisateurs ayant des goûts proches ont apprécié un élément, celui-ci pourrait vous plaire aussi. Dans une boutique, les associations « les clients qui ont acheté cet article ont également choisi… » illustrent cette approche. Le système peut comparer des profils, des produits, ou les deux, sans devoir comprendre en détail le contenu lui-même.
La factorisation de matrices est une méthode historique de cette famille. Elle représente les utilisateurs et les éléments dans un espace de caractéristiques latentes, puis estime les préférences manquantes. Le Netflix Prize, lancé en 2006, a contribué à populariser ces travaux : le concours récompensait une amélioration importante de la précision des prédictions de notes. L’histoire est utile, mais elle ne signifie pas qu’une méthode ancienne suffit à construire un moteur moderne.
La difficulté principale est le démarrage à froid. Un nouvel utilisateur n’a pas encore d’historique ; un article publié ce matin n’a reçu aucune interaction. Le système manque alors de matière pour établir des ressemblances fiables. Une question de départ, une catégorie choisie ou des caractéristiques descriptives peuvent aider à faire les premières propositions.
Le contenu réduit le besoin d’historique, mais peut enfermer
Le filtrage basé sur le contenu compare les propriétés des éléments. Pour un film, il peut considérer le genre, les thèmes ou les personnes au générique ; pour un article, les sujets et le vocabulaire ; pour une chaussure, la taille, la matière et l’usage prévu. Des méthodes textuelles comme TF-IDF, ou des représentations sémantiques plus récentes, aident à rapprocher des contenus qui parlent de sujets voisins avec des mots différents.
Cette approche permet à Atelier Nord de recommander un sac nouvellement ajouté, dès lors que ses dimensions, son poids et son usage sont renseignés. En revanche, si le visiteur a consulté un sac bleu, le moteur risque de lui proposer uniquement d’autres sacs bleus. La cohérence devient répétition lorsque le système ne laisse aucune place à l’exploration.
Les systèmes hybrides combinent donc signaux de contenu et comportements collectifs. Ils peuvent utiliser les caractéristiques d’un produit pour traiter sa nouveauté, puis enrichir le classement quand les achats s’accumulent. C’est souvent plus réaliste qu’un choix de méthode dicté par la mode ou par la seule présence du mot « IA » dans une présentation commerciale.
Le bon modèle n’est pas le plus spectaculaire : c’est celui qui fonctionne avec les données réellement disponibles.
Le pipeline d’un moteur moderne : sélectionner, classer, ajuster
Dans un service à grande échelle, recommander ne consiste généralement pas à appliquer un modèle unique à chaque élément du catalogue. Le catalogue peut compter des millions de références et le classement doit parfois être produit en une fraction de seconde. Une architecture en plusieurs étapes permet de garder un système à la fois rapide et utile.
Premier étage : retrouver des candidats pertinents
La phase de retrieval, ou génération de candidats, réduit d’abord un très grand catalogue à une liste de taille raisonnable. Elle peut réunir des produits proches de l’historique, des contenus populaires dans une catégorie, des nouveautés et des options issues de règles métier. À ce stade, la priorité est la vitesse et la couverture : mieux vaut sélectionner plusieurs pistes plausibles que manquer une option intéressante.
Pour Atelier Nord, cette première liste pourrait contenir des sacs comparables, des accessoires compatibles et quelques nouveautés de randonnée. Elle ne constitue pas encore la page finale. Elle sert de matière au classement suivant, comme un panier de candidats que l’on va examiner plus finement.
Deuxième étage : noter les options
Le scoring attribue un score à chaque candidat en combinant plusieurs signaux : proximité avec les consultations, probabilité d’achat, compatibilité avec le panier ou préférences observées. Des modèles d’apprentissage automatique peuvent effectuer ce calcul. Les architectures dites « two-tower », par exemple, représentent séparément l’utilisateur et l’élément avant de mesurer leur proximité dans un espace commun.
Un score ne doit pas être confondu avec une valeur objective. Il correspond à un objectif choisi et à des données d’entraînement. Si le système apprend surtout à prédire les clics, il risque de favoriser des images attirantes sans que les recommandations génèrent des achats satisfaisants. La métrique doit donc être raccord avec le besoin réel du produit.
Troisième étage : réordonner avec des règles de qualité
Le reranking ajuste enfin la liste. Il peut limiter les répétitions, faire une place aux nouveautés, tenir compte des stocks ou exclure des éléments inadaptés. Cette étape évite qu’une prédiction statistiquement forte produise une expérience médiocre. Une page avec dix variantes presque identiques peut avoir de bons scores individuels et pourtant manquer son objectif global.
Ce découpage aide aussi les équipes à diagnostiquer les problèmes. Si les candidats ne comprennent jamais une nouveauté, le souci se situe en amont. Si une bonne sélection est mal ordonnée, le scoring mérite une analyse. Si les recommandations sont pertinentes mais monotones, le réordonnancement doit introduire davantage de diversité.
Ce que l’IA générative change réellement
Les grands modèles de langage peuvent enrichir plusieurs parties de cette chaîne. Des embeddings sémantiques rapprochent des textes qui partagent une idée sans employer les mêmes termes : un article sur la hausse des taux peut être associé à un guide sur le coût d’un crédit immobilier. Cela améliore la compréhension du catalogue, notamment lorsque les descriptions sont rédigées de façons différentes.
Un modèle génératif peut également produire une explication lisible, par exemple : « proposé parce que vous avez consulté des sacs de randonnée légers ». Il peut enfin soutenir une recherche conversationnelle : « je cherche un sac pour une sortie à la journée, avec une poche à eau ». En revanche, l’utiliser seul pour trier en temps réel un vaste catalogue peut être coûteux, lent et imprévisible. Il vaut mieux l’intégrer à des étapes précises que lui confier tout le moteur.
Pour comprendre les briques techniques derrière ces usages, ce guide sur les réseaux de neurones en intelligence artificielle apporte un éclairage complémentaire. L’IA générative aide à mieux représenter ou expliquer une suggestion ; elle ne remplace ni l’objectif produit ni l’évaluation.
Un moteur solide sépare la recherche de candidats, la prédiction et les arbitrages finaux.
Personnalisation : gain de temps, biais et moyens de reprendre la main
La recommandation répond à un problème concret : il y a souvent trop d’options pour tout parcourir. Sur une plateforme de musique, elle peut proposer une sélection adaptée à un trajet ; dans une boutique, elle peut faire apparaître un accessoire compatible ; sur un réseau social, elle hiérarchise les publications d’un fil. Cette réduction du travail de recherche améliore le confort, surtout lorsque le catalogue est vaste.
Pour une entreprise, la personnalisation peut aussi soutenir la conversion ou la fidélité. Des analyses publiées par McKinsey ont estimé que les entreprises maîtrisant la personnalisation pouvaient observer des gains de revenus, mais ces résultats varient selon le secteur, la méthode et la qualité de l’exécution. Ils ne garantissent pas qu’ajouter un bloc de suggestions augmentera automatiquement les ventes d’un site donné.
La bulle de filtres et le biais de popularité
Le risque apparaît lorsque le système reproduit trop fidèlement les signaux passés. Si vous regardez un documentaire par curiosité, puis que la plateforme interprète cette visite comme une préférence durable, elle peut multiplier les contenus similaires. La page devient plus prévisible, mais parfois moins intéressante. La personnalisation n’est pas nécessairement une bulle ; elle peut le devenir si les propositions ne laissent aucune place à la diversité.
Le biais de popularité suit une autre boucle. Les éléments déjà visibles obtiennent davantage de clics, ce qui leur donne plus de chances d’être recommandés à nouveau. Les nouveautés et les contenus de niche restent alors dans l’ombre, non parce qu’ils sont moins pertinents, mais parce qu’ils disposent de moins d’interactions initiales.
Il faut aussi distinguer engagement et bénéfice utilisateur. Un classement optimisé uniquement pour le temps passé peut privilégier des contenus qui retiennent l’attention, sans améliorer la satisfaction ou la qualité de l’information. Les choix de métriques ont donc des effets concrets : l’algorithme optimise ce que l’équipe lui demande de mesurer.
Des gestes simples pour modifier les suggestions
Un utilisateur peut envoyer de nouveaux signaux et corriger certaines interprétations. Les options varient selon les plateformes, mais les actions suivantes sont souvent utiles :
- Utiliser les commandes « pas intéressé » ou de masquage lorsqu’elles existent.
- Effacer ou mettre en pause l’historique si une recherche ponctuelle a déformé les suggestions.
- Créer des profils séparés lorsque plusieurs personnes partagent le même compte.
- Consulter volontairement des sujets différents pour élargir les indices observés.
- Rechercher un contenu directement plutôt que de dépendre uniquement du fil personnalisé.
Ces gestes ne modifient pas toujours instantanément un classement. Certaines plateformes tiennent compte de signaux récents, d’autres conservent des préférences à plus long terme. Il n’existe pas de bouton magique universel : la qualité des recommandations évolue à mesure que les indices changent.
Une entreprise peut appliquer la même prudence en donnant davantage de diversité à son moteur. Atelier Nord pourrait réserver une place à des produits nouveaux ou à des alternatives moins populaires, puis vérifier si elles apportent des clics qualifiés, des ventes ou simplement une meilleure exploration du catalogue. La découverte doit être évaluée, pas ajoutée au hasard.
Une recommandation utile doit faciliter le choix sans réduire toutes les options à ce qui a déjà fonctionné.
Créer un système de recommandation utile et conforme dans son business
Une petite entreprise n’a pas besoin de reproduire l’infrastructure de Netflix. Elle a besoin d’un problème précis à résoudre et d’une façon fiable de mesurer le résultat. Sur un site marchand, le premier test peut porter sur des produits complémentaires. Pour un média, il peut s’agir d’articles liés à la lecture en cours. Dans les deux cas, le système doit améliorer l’expérience, pas seulement ajouter une couche technologique.
Partir de l’objectif et des données disponibles
Choisissez un objectif principal : améliorer le taux d’ajout au panier, aider les lecteurs à poursuivre une recherche, réduire les abandons ou augmenter les achats complémentaires. Évitez de poursuivre plusieurs indicateurs sans hiérarchie. Une hausse des clics sur les recommandations ne prouve pas, à elle seule, une progression du chiffre d’affaires ou de la satisfaction.
Ensuite, faites l’inventaire des données utiles et de leur qualité. Les produits doivent avoir des descriptions cohérentes, des catégories fiables et des informations de stock actualisées. Les événements doivent être correctement enregistrés : consultation, ajout au panier, achat ou retrait d’un produit. Une donnée propre dans un tableau simple vaut souvent mieux qu’un modèle complexe alimenté par des événements incomplets.
Choisir une solution adaptée, puis tester
Des services spécialisés, comme Algolia Recommend, Recombee ou Amazon Personalize, proposent des briques prêtes à configurer. Des bibliothèques open source telles qu’Implicit, Surprise ou TensorFlow Recommenders donnent plus de contrôle, mais demandent des compétences techniques et de la maintenance. Le choix dépend du volume, du budget, des intégrations déjà en place et des exigences de confidentialité.
Commencez par un emplacement limité, par exemple un bloc « produits similaires » sur une fiche produit. Comparez une version avec recommandations à une version témoin, en définissant à l’avance la durée et les indicateurs suivis. Mesurez les ventes et les retours, mais aussi les clics, la disponibilité des articles et la diversité des résultats. Un test bien cadré révèle parfois qu’une règle métier simple surpasse un modèle plus sophistiqué.
Intégrer les obligations européennes dès la conception
Le règlement européen sur les services numériques, ou DSA, s’applique depuis le 17 février 2024. Ses obligations les plus spécifiques concernant les systèmes de recommandation visent notamment les très grandes plateformes en ligne et les très grands moteurs de recherche désignés. Elles portent sur l’explication des principaux paramètres et, pour ces acteurs, sur la mise à disposition d’au moins une option de recommandation qui ne repose pas sur le profilage.
Il serait donc inexact de présenter chaque petite boutique comme soumise exactement aux mêmes obligations qu’un réseau social mondial. Cela ne dispense pas les entreprises de réfléchir à la transparence, à la protection des données et aux règles applicables à leur activité. Le RGPD encadre notamment les données personnelles et certaines décisions automatisées ayant des effets juridiques ou significatifs ; la situation doit être évaluée selon l’usage concret, pas seulement selon le nom du modèle employé.
Une documentation pratique peut préciser les signaux utilisés, l’objectif poursuivi, les critères d’exclusion et la façon de corriger une recommandation inadaptée. Pour un projet qui touche à des sujets sensibles, une revue de conformité et un mécanisme de contestation sont des garde-fous raisonnables. La réflexion sur l’IA éthique et l’innovation aide à intégrer ces enjeux au lieu de les traiter après le lancement.
Avant de déployer, vérifiez que vous pouvez répondre à ces questions : pourquoi cet élément est-il proposé, quelles données ont contribué au classement, comment l’utilisateur peut-il ajuster ses préférences et quel indicateur prouve l’utilité de la fonctionnalité ? Cette discipline relie produit, données et conformité sans transformer le projet en usine à gaz.
Commencez avec un usage limité, une mesure claire et des règles compréhensibles ; automatisez davantage seulement lorsque les résultats le justifient.
Un algorithme de recommandation utilise-t-il toujours l’intelligence artificielle ?
Non. Certains systèmes utilisent des règles ou des scores simples ; d’autres s’appuient sur l’apprentissage automatique. Le terme IA ne suffit pas à décrire la méthode ni à garantir la qualité des suggestions.
Pourquoi les recommandations sont-elles différentes d’un utilisateur à l’autre ?
Chaque classement dépend d’interactions, d’un historique et parfois d’un contexte différents. Deux personnes consultant la même plateforme peuvent donc voir des sélections distinctes, même au même moment.
Qu’est-ce que le démarrage à froid ?
C’est le manque de données disponibles pour recommander à un nouvel utilisateur ou pour un nouvel élément du catalogue. Des catégories choisies, des caractéristiques descriptives ou une combinaison de méthodes peuvent limiter ce problème.
Peut-on réinitialiser ses recommandations ?
Certaines plateformes permettent d’effacer l’historique, de changer de profil ou de signaler qu’un contenu ne vous intéresse pas. L’effet dépend du service et peut prendre du temps, car plusieurs types de signaux peuvent continuer à influencer le classement.
Le DSA interdit-il les recommandations personnalisées ?
Non. Le DSA encadre notamment la transparence des systèmes et prévoit, pour les très grandes plateformes désignées, une option de recommandation qui ne repose pas sur le profilage. Il ne bannit pas la personnalisation.