Une base clients remplie de commandes, de formulaires et d’interactions peut sembler utile sans être réellement exploitée. Pourtant, derrière ces lignes s’accumulent des signaux précieux : produits souvent achetés ensemble, clients qui risquent de partir, demandes qui reviennent dans le support ou comportements inhabituels. Le data mining, ou exploration de données, sert à faire émerger ces motifs pour éclairer des décisions concrètes. Il ne transforme pas automatiquement une entreprise. Il aide à poser de meilleures questions et à vérifier, avec des données, si une intuition tient la route.
Pour une petite boutique en ligne, l’enjeu n’est pas de bâtir une usine à intelligence artificielle. Il peut suffire d’examiner les commandes passées pour adapter les recommandations, mieux prévoir les stocks ou repérer une anomalie de paiement. Le travail demande toutefois une méthode : définir un objectif, vérifier la qualité des données, choisir une analyse adaptée, puis mesurer l’effet d’une décision. Un modèle sophistiqué alimenté par des informations incomplètes reste un mauvais raccourci. La valeur naît de l’association entre données fiables, compréhension du métier et mise en pratique.
En bref
- Le data mining repère des tendances, des relations et des anomalies dans de grands ensembles de données.
- La qualité des informations et la définition d’un objectif métier comptent davantage que le choix d’un algorithme à la mode.
- Classification, clustering, association et régression répondent à des questions différentes.
- Python, R et des plateformes visuelles facilitent l’exploration, mais ne remplacent pas le jugement humain.
- Les résultats doivent être testés dans les opérations, avec une attention réelle à la confidentialité et aux biais.
Data mining : transformer une base de données en décisions utiles
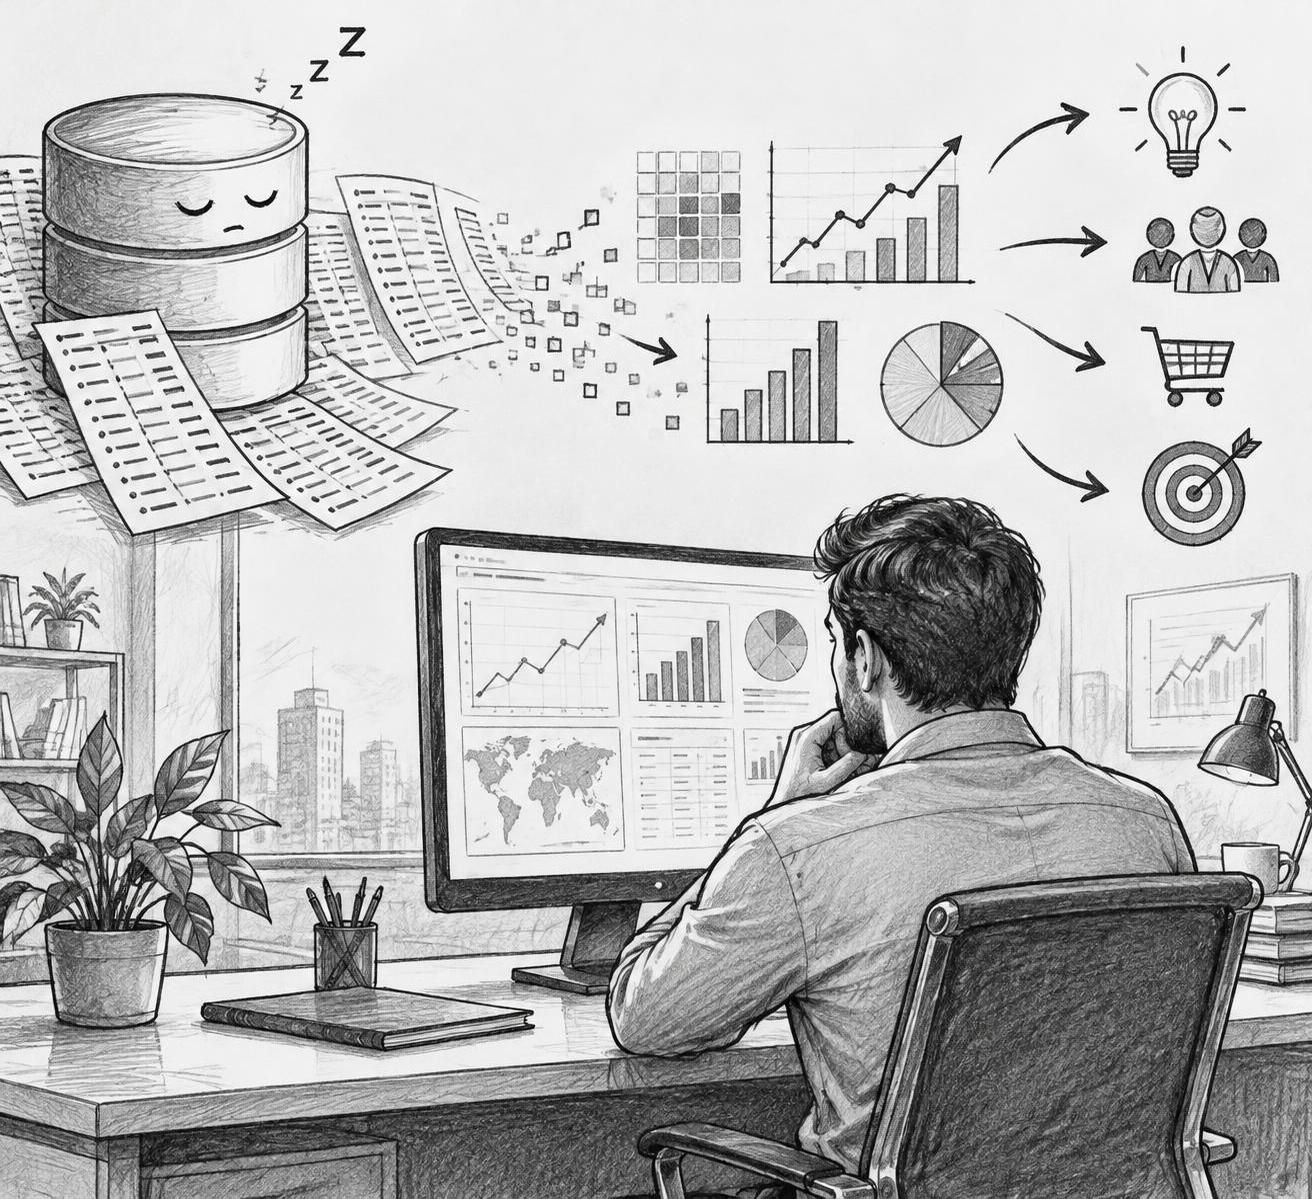
Le data mining consiste à explorer des données pour y découvrir des structures qui ne sont pas évidentes au premier regard. Il mobilise des méthodes statistiques et des algorithmes d’apprentissage automatique pour classer des cas, regrouper des profils, détecter des anomalies ou estimer une valeur future. On parle aussi de fouille de données ou d’exploration de données. Dans la pratique, cette démarche s’appuie souvent sur plusieurs sources : commandes, outils de relation client, statistiques de trafic, tickets d’assistance ou données issues d’objets connectés.
Imaginez Nora, qui dirige une boutique de matériel de randonnée. Elle dispose de trois ans de commandes, mais consulte surtout son chiffre d’affaires mensuel. Une exploration plus fine révèle que les acheteurs d’un sac de couchage achètent fréquemment une lampe frontale dans les jours suivants. Ce constat peut guider une recommandation après achat ou la création d’un lot. Le modèle ne décide pas à sa place : il met en évidence une relation à tester, puis les résultats commerciaux indiquent si l’action fonctionne.
Cette différence est essentielle. Une corrélation n’explique pas toujours une cause. Si les ventes de parapluies augmentent en même temps que celles d’un produit, cela ne prouve pas que l’un provoque l’achat de l’autre. La saison, une campagne publicitaire ou une variation du trafic peut expliquer les deux phénomènes. Le data mining fait remonter des pistes ; l’analyse métier permet de les interpréter avec prudence.
De l’exploration statistique au machine learning
Les premières approches d’analyse de données reposaient surtout sur des statistiques et des bases décisionnelles. L’augmentation des capacités de stockage et de calcul a ensuite rendu possible le traitement d’ensembles plus volumineux et variés. Aujourd’hui, le machine learning élargit les possibilités, notamment pour analyser des comportements complexes ou des textes. Cela ne rend pas les méthodes classiques obsolètes : une segmentation simple ou une régression bien comprise peut être plus utile qu’un système difficile à expliquer.
Dans une entreprise, l’objectif est rarement de « faire de l’IA » pour elle-même. Il s’agit plutôt de réduire les ruptures de stock, d’améliorer la fidélisation, d’orienter une campagne marketing ou de détecter des transactions suspectes. Le bon niveau de sophistication dépend du coût de l’erreur, du volume disponible et de la capacité des équipes à agir sur le résultat. Pour comprendre comment les données sont organisées en amont, le sujet des infrastructures et de la préparation des données complète utilement cette réflexion.
Insight : une base devient stratégique quand elle aide à choisir une action mesurable, pas quand elle contient simplement davantage de lignes.
Choisir un objectif de data mining avant de choisir un algorithme
Une exploration efficace commence par une question commerciale précise. « Que peut-on apprendre de ces données ? » est trop vague pour guider un projet. « Quels clients n’ont pas commandé depuis quatre-vingt-dix jours et répondent habituellement à une offre de réactivation ? » fournit une direction plus exploitable. La question détermine les données nécessaires, la méthode d’analyse et les critères permettant de juger le résultat.
Nora pourrait chercher à augmenter la valeur moyenne du panier. Avant de lancer un modèle, elle doit préciser ce que cette mesure signifie pour son activité : panier moyen hors frais de livraison, marge par commande ou revenus par visiteur ? Ces indicateurs ne racontent pas la même histoire. Une promotion peut augmenter le montant dépensé tout en réduisant la marge. Une analyse utile relie donc les découvertes aux objectifs réels, plutôt qu’à un chiffre isolé facile à présenter.
Quatre familles de questions fréquentes
La segmentation cherche des groupes de comportements proches. Une boutique peut distinguer les acheteurs réguliers, les visiteurs attirés par les promotions et les clients qui achètent des produits haut de gamme. Le clustering forme ces groupes sans étiquette préalable, ce qui est intéressant quand les profils ne sont pas connus d’avance. Les segments obtenus doivent ensuite être examinés : un groupe mathématiquement distinct n’est pas forcément utile pour une campagne ou une décision de stock.
La classification attribue une catégorie connue à de nouveaux cas. Un modèle peut estimer si une demande ressemble à un spam ou si un client présente un risque de résiliation. La régression, elle, estime une valeur numérique, comme la demande attendue pour un produit. Enfin, l’analyse d’association identifie des éléments souvent observés ensemble. C’est la logique derrière certaines recommandations de produits, à condition de vérifier que les associations sont assez fréquentes et rentables pour justifier une action.
Il existe aussi la détection d’anomalies, utile pour signaler une transaction atypique, un pic d’erreurs techniques ou une consommation inhabituelle. Un signal ne constitue pas une preuve de fraude. Si un système bloque automatiquement une commande légitime, le coût de faux positifs peut dépasser le bénéfice attendu. Une première mise en œuvre peut donc se limiter à classer les alertes par priorité pour qu’une personne les vérifie.
Pour rendre le projet concret, l’équipe peut fixer une mesure avant le test : taux de conversion, marge, délai de traitement ou proportion d’alertes confirmées. Elle compare ensuite une période de référence à un groupe exposé à la nouvelle action, sans attribuer au modèle une amélioration due à une autre campagne. Cette discipline évite les démonstrations séduisantes mais impossibles à relier à un impact réel.
Insight : la meilleure méthode est celle qui répond clairement à une question métier et dont l’effet peut être vérifié.
Préparer les données : le travail discret qui fait la différence
La qualité d’un modèle dépend directement de celle des données qu’il reçoit. Des doublons, des dates incohérentes, des champs vides ou des identifiants mal raccordés peuvent fausser les résultats. Une boutique qui enregistre le même client sous plusieurs adresses électroniques risque, par exemple, de sous-estimer sa fréquence d’achat. Un système d’inventaire mis à jour avec retard peut faire croire à une rupture plus longue qu’elle ne l’a été.
La préparation commence par un inventaire des sources et de leur signification. Il faut savoir quand une donnée est créée, qui la met à jour, quelles valeurs sont possibles et si elle peut être associée à une personne. Une colonne appelée « statut » peut vouloir dire « commande payée » dans un outil et « commande préparée » dans un autre. Les réunir sans vérifier les définitions revient à mélanger des mesures différentes sous une même étiquette.
Un processus simple, mais complet
- Définir la question : préciser le problème, la population concernée et la décision qui pourra être prise.
- Rassembler les sources : sélectionner uniquement les données utiles, qu’elles proviennent du CRM, des commandes, du site ou du support.
- Nettoyer et préparer : traiter les valeurs manquantes, harmoniser les formats, repérer les doublons et documenter les choix.
- Construire puis évaluer le modèle : le tester sur des données qui n’ont pas servi à son entraînement et examiner ses erreurs.
- Déployer avec suivi : intégrer le résultat dans un processus réel, surveiller les performances et corriger si les comportements évoluent.
Pour une prédiction dans le temps, la séparation entre données d’entraînement et données de test doit respecter la chronologie. Si le modèle apprend avec des informations apparues après l’événement qu’il est censé prévoir, l’évaluation sera artificiellement optimiste. Une prévision de ventes peut ainsi sembler excellente sur le papier parce qu’elle a indirectement « vu » des données futures. Le test doit reproduire les conditions auxquelles le système sera confronté une fois en service.
Le data warehouse ou entrepôt de données aide à centraliser des informations issues de plusieurs outils et à les rendre cohérentes pour l’analyse. Les services cloud facilitent aussi le traitement de volumes importants, sans imposer nécessairement l’achat immédiat d’infrastructures internes. Mais le cloud ne résout ni les incohérences métier ni les problèmes d’accès. Il faut contrôler qui peut consulter les données, combien de temps elles sont conservées et comment elles sont protégées.
Les données issues de l’Internet des objets accentuent ces enjeux : capteurs, équipements et applications peuvent générer des flux continus, utiles pour surveiller des stocks ou anticiper une panne. Collecter tout ce qui est disponible n’est pas une stratégie. Mieux vaut retenir les signaux nécessaires, avec un niveau de précision et une fréquence adaptés à la décision.
Insight : le nettoyage n’est pas une étape secondaire ; c’est la condition pour que les résultats méritent confiance.
Techniques et outils de data mining pour passer de l’analyse au test
Les méthodes se choisissent en fonction de la question et de la nature des données. Les arbres de décision produisent des règles relativement faciles à expliquer : par exemple, une commande peut être signalée si plusieurs caractéristiques inhabituelles apparaissent simultanément. Les forêts aléatoires combinent plusieurs arbres pour améliorer la robustesse dans certains cas, au prix d’une interprétation moins directe. Les réseaux de neurones peuvent traiter des relations complexes, mais ils demandent souvent plus de données, de calcul et de compétences.
Les méthodes statistiques gardent une place centrale. Une régression estime les relations entre variables et peut servir à prévoir une demande ou à comprendre les facteurs associés à une conversion. Les modèles séquentiels et les séries temporelles sont adaptés aux données ordonnées, comme les ventes quotidiennes. Les SVM peuvent servir à classer des observations, tandis que les techniques de clustering recherchent des groupes sans catégories définies à l’avance.
Choisir un outil adapté à son équipe
Python est polyvalent et dispose de bibliothèques reconnues pour manipuler les données, entraîner des modèles et produire des visualisations. Des outils comme pandas, scikit-learn ou TensorFlow couvrent des usages différents, du nettoyage aux modèles avancés. R est apprécié pour l’analyse statistique et la visualisation. Le choix entre les deux dépend souvent des compétences en place, des intégrations nécessaires et de la facilité à maintenir le travail dans le temps.
Les plateformes visuelles comme KNIME, Orange ou RapidMiner permettent de construire des workflows sans écrire immédiatement beaucoup de code. Elles sont pratiques pour explorer un jeu de données ou prototyper une chaîne d’analyse. Des solutions d’entreprise telles que SAS Enterprise Miner répondent à des contextes plus structurés, avec des besoins de gouvernance et de déploiement spécifiques. Un outil plus coûteux n’est pas automatiquement plus pertinent pour une petite équipe.
| Besoin | Technique possible | Exemple opérationnel |
|---|---|---|
| Créer des groupes de clients | Clustering | Adapter les messages à différents comportements d’achat |
| Attribuer une catégorie | Classification | Prioriser les demandes suspectes ou les risques de départ |
| Estimer une valeur | Régression | Prévoir une demande ou un montant de vente |
| Repérer des achats liés | Association | Tester une recommandation de produit complémentaire |
| Déceler un comportement inhabituel | Détection d’anomalies | Faire examiner une transaction atypique |
Le text mining complète ces méthodes lorsque l’information se trouve dans des avis, des demandes d’assistance ou des réponses à des enquêtes. Une analyse peut regrouper les commentaires par thèmes récurrents, comme la livraison, la taille d’un produit ou la difficulté d’utilisation. Les résultats ne doivent pas être pris au pied de la lettre : ironie, contexte et formulations ambiguës compliquent l’interprétation automatique. Un échantillon relu par une personne aide à vérifier que les catégories sont cohérentes.
Un workflow reproductible vaut mieux qu’une suite d’analyses manuelles impossibles à refaire. Il documente les transformations, les paramètres et les limites du modèle. L’équipe peut ainsi comparer une nouvelle version à l’ancienne, retrouver l’origine d’un résultat et éviter qu’une modification silencieuse change les décisions.
Insight : le bon outil est celui que l’équipe peut comprendre, vérifier et maintenir après le premier prototype.
Applications du data mining, limites et usage responsable
Dans le commerce, l’analyse des transactions aide à mieux segmenter les clients, repérer des produits fréquemment associés et ajuster la prévision des stocks. Un e-commerçant peut tester une recommandation après achat, puis comparer le panier et la marge des clients exposés à ceux d’un groupe témoin. Si les ventes progressent mais que les retours augmentent aussi, le résultat mérite une analyse plus fine. Un indicateur unique ne suffit pas pour valider une stratégie.
En finance, des modèles peuvent signaler des opérations atypiques ou contribuer à l’évaluation d’un risque. Dans la santé, l’exploration de données peut aider à étudier des dossiers ou à identifier des tendances, mais elle ne remplace ni le diagnostic ni l’avis clinique. Dans l’industrie, l’analyse des capteurs peut détecter des signaux annonçant une défaillance et permettre une maintenance préventive. Dans chaque secteur, les conséquences d’une erreur et le niveau de supervision nécessaire diffèrent.
Le marketing digital bénéficie aussi d’analyses plus modestes, souvent plus directement actionnables. Les parcours de navigation et les demandes adressées au support peuvent révéler une page peu claire ou une étape de paiement qui décourage les visiteurs. Il est alors possible de formuler une hypothèse, de modifier une page et de mesurer la conversion par un test contrôlé. Automatiser la personnalisation avant de comprendre le problème risque simplement de diffuser plus vite une expérience médiocre.
Confidentialité, biais et surveillance des résultats
Les données personnelles imposent des règles de collecte, d’accès et de conservation. Une entreprise doit pouvoir expliquer pourquoi elle analyse une information et limiter les usages à ce qui est nécessaire. Les modèles peuvent également reproduire des biais présents dans l’historique : si certaines catégories de clients ont été moins bien servies, un système entraîné sur ces comportements peut prolonger l’inégalité. Des contrôles réguliers et une possibilité de révision humaine sont donc indispensables pour les décisions sensibles.
Le cadre européen relatif à l’intelligence artificielle évolue et les obligations dépendent notamment du type de système et de son niveau de risque. Une équipe qui envisage de déployer un modèle doit suivre les exigences applicables plutôt que supposer qu’un outil d’analyse échappe à toute règle. Le point sur la régulation de l’IA en Europe permet de replacer ces enjeux dans leur contexte. Pour les usages de sécurité, la détection de comportements inhabituels peut aussi compléter une stratégie de prévention du spear phishing visant les dirigeants, sans se substituer aux protections humaines et techniques.
Enfin, un modèle perd en pertinence lorsque les comportements changent. Une nouvelle politique tarifaire, une saison différente ou une modification du parcours d’achat peut rendre ses anciennes prédictions moins fiables. Il faut donc suivre des indicateurs après le déploiement, documenter les dérives et prévoir une procédure de retour arrière. La performance initiale n’est pas une garantie permanente.
Insight : la valeur du data mining se mesure à l’amélioration durable d’une décision, avec des garde-fous proportionnés à ses conséquences.
Questions fréquentes sur le data mining
Quelle différence entre data mining et analyse de données ?
L’analyse de données couvre un ensemble large de pratiques, du reporting à l’étude statistique. Le data mining désigne plus précisément la recherche de modèles, de relations ou d’anomalies dans des ensembles de données, souvent à l’aide d’algorithmes.
Faut-il beaucoup de données pour commencer ?
Pas nécessairement. Un jeu de données limité mais propre peut suffire pour tester une hypothèse simple. Il faut surtout disposer d’informations pertinentes, correctement définies et assez représentatives de la situation à analyser.
Peut-on faire du data mining sans programmer ?
Oui. Des plateformes visuelles comme Orange ou KNIME permettent de créer des workflows d’analyse sans écrire beaucoup de code. Pour des traitements personnalisés ou des intégrations avancées, Python et R offrent davantage de souplesse.
Comment vérifier qu’un modèle apporte un bénéfice réel ?
Définissez un indicateur métier avant le déploiement, puis comparez les résultats à une référence ou à un groupe témoin. Mesurez également les erreurs, les coûts induits et les effets secondaires, comme les faux positifs ou la baisse de marge.