Un algorithme n’est pas forcément une intelligence artificielle inaccessible, ni une boîte noire réservée aux grandes plateformes. C’est une méthode composée d’étapes précises pour résoudre un problème : classer des produits, retrouver une facture ou choisir les vidéos les plus pertinentes pour un utilisateur. Un tri de liste peut tenir en quelques lignes ; un moteur de recommandation, lui, combine des données, des modèles et des règles métier. Entre les deux, une même logique guide le travail : définir un objectif, traiter des informations, puis vérifier le résultat.
Cette progression intéresse autant les développeurs que les entrepreneurs. Comprendre ce qui se passe sous le capot aide à sélectionner les bons outils, à repérer les limites d’une automatisation et à mesurer son impact sur l’expérience client. Des exemples simples permettent de saisir les fondations avant d’aborder des systèmes plus avancés. Car automatiser sans comprendre, c’est parfois accélérer ses erreurs.
En bref
- Un algorithme décrit une suite d’instructions permettant de résoudre un problème défini.
- Les tris et les recherches montrent comment choisir une méthode selon la taille et l’organisation des données.
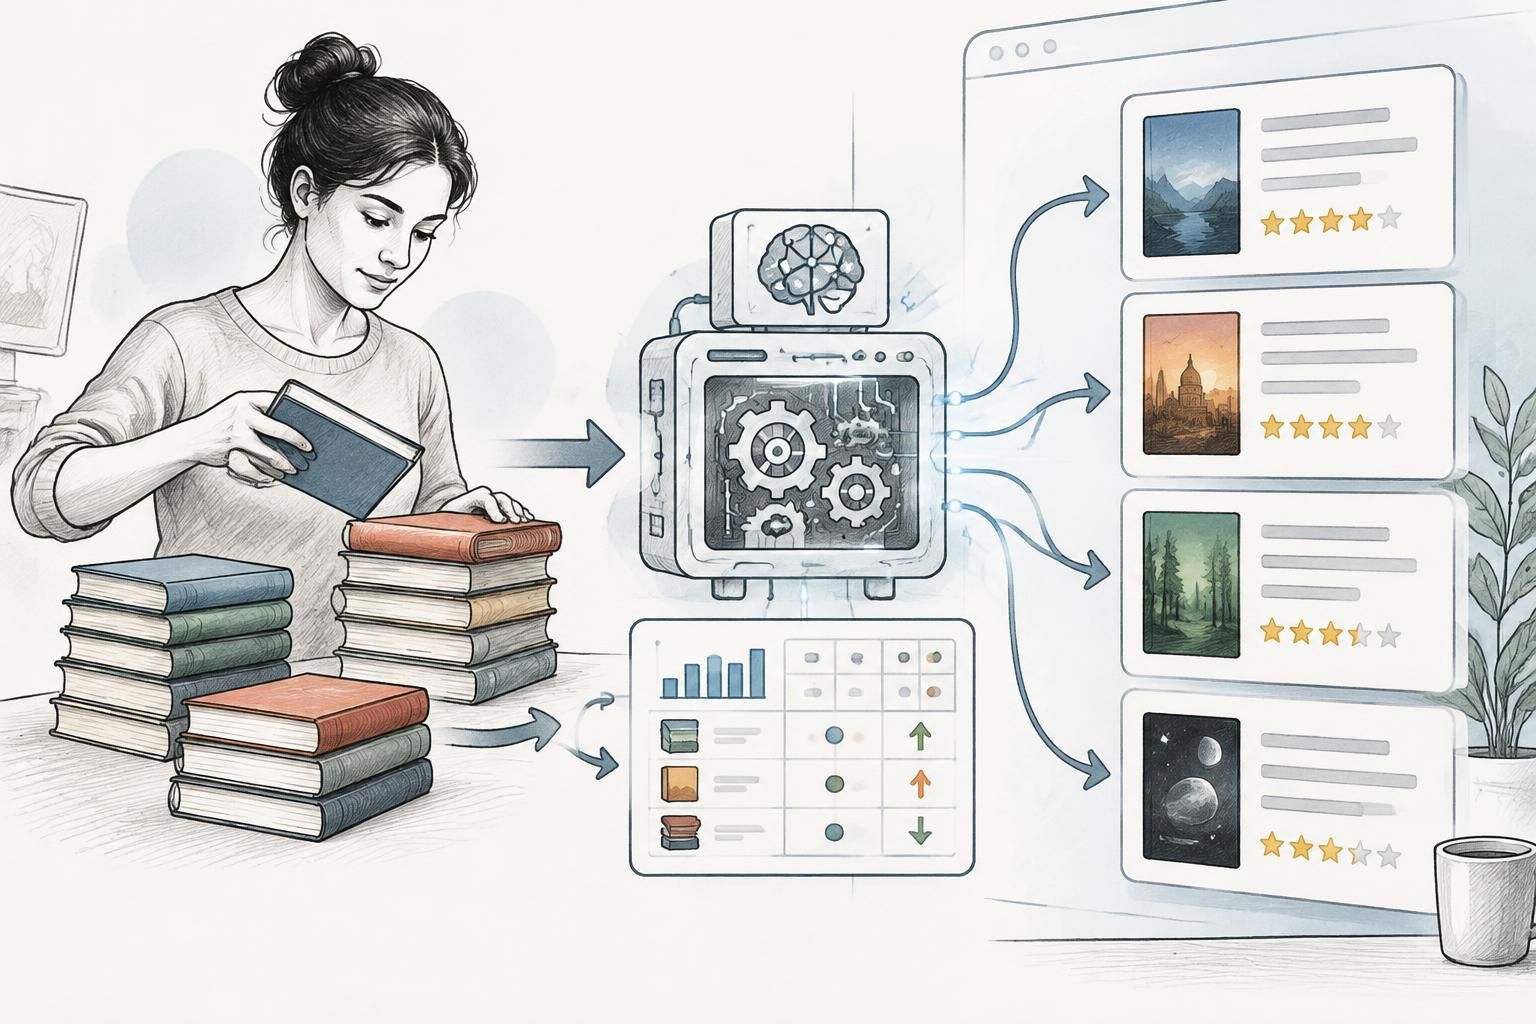
- Un moteur de recommandation récupère des candidats, les classe et ajuste parfois la sélection finale.
- La qualité des données, la latence, les biais et la protection de la vie privée comptent autant que le modèle.
- Il est possible de commencer avec des règles simples, puis d’optimiser à partir de mesures concrètes.
Exemples d’algorithmes de tri : organiser une liste sans complexité inutile
Imaginez une boutique en ligne qui affiche deux cents produits et veut les présenter du moins cher au plus cher. L’algorithme de tri prend une liste d’éléments et les réorganise selon une règle : prix croissant, date de publication, popularité ou ordre alphabétique. La règle doit être claire avant de choisir une méthode. Sinon, même un programme techniquement correct risque de produire un résultat inutile pour le client.
Le tri à bulles illustre facilement le principe. Il compare deux éléments voisins et les échange si leur ordre est incorrect, puis recommence jusqu’à ce que la liste soit rangée. Avec une poignée de valeurs, cette méthode est pratique pour comprendre les comparaisons et les échanges. Sur une grande base de produits, elle devient lente : chaque passage peut entraîner de nombreuses vérifications. C’est un bon outil pédagogique, mais rarement le choix adapté à un catalogue réel.
Tri par sélection et tri par insertion : deux logiques faciles à visualiser
Le tri par sélection parcourt la partie encore désordonnée, repère le plus petit élément, puis le place à la prochaine position libre. Pour classer les prix 18, 7, 12 et 4, il cherche d’abord 4, le met en tête, puis recommence avec les valeurs restantes. Cette stratégie limite le nombre d’échanges, mais elle continue à examiner beaucoup d’éléments lorsque la liste grossit.
Le tri par insertion fonctionne comme une main qui range des cartes. On prend une valeur, on la compare aux éléments déjà rangés, puis on l’insère à l’endroit approprié. Pour une liste presque ordonnée, il peut être efficace et simple à maintenir. Dans un tableau de bord où quelques nouveaux événements sont ajoutés à une série déjà triée, cette approche peut être plus pertinente qu’un tri complet à chaque mise à jour.
Les langages de programmation proposent généralement des fonctions de tri optimisées, adaptées à des situations variées. Dans un projet web, il est souvent préférable de les utiliser plutôt que de réécrire un algorithme sans nécessité. L’effort doit porter sur les détails métier : que faire si deux produits ont le même prix ? Faut-il les départager selon le stock, la marge ou les avis clients ?
Choisir selon les données, pas selon le prestige de l’algorithme
Une méthode se juge selon le volume à traiter, la fréquence des mises à jour, la mémoire disponible et le temps de réponse attendu. Une liste de trente catégories n’impose pas la même architecture qu’un flux de millions d’événements. Cette idée rejoint les bases présentées dans un guide sur la définition d’un algorithme et ses exemples : la solution commence par une consigne formulée sans ambiguïté.
Un marchand peut tester deux classements sur un échantillon : prix seul, puis prix combiné à la disponibilité. Il mesure ensuite les clics, les ajouts au panier et les ventes, sans attribuer automatiquement chaque variation à l’algorithme. Une baisse du taux de conversion peut venir d’une rupture de stock ou d’une campagne différente. Un tri utile n’est pas seulement ordonné : il correspond à une décision compréhensible pour l’utilisateur.
Algorithmes de recherche : retrouver une information plus vite
Classer les données est une chose ; trouver un élément en est une autre. La recherche séquentielle examine les valeurs une par une jusqu’à repérer la cible ou atteindre la fin de la liste. Pour retrouver une commande dans un petit fichier non trié, cette méthode est directe. Elle ne demande pas de préparation particulière et reste robuste tant que le volume est raisonnable.
Mais si la liste est déjà ordonnée, la recherche dichotomique peut réduire fortement le nombre de vérifications. Elle compare la cible à l’élément du milieu. Si la valeur cherchée est plus petite, elle écarte la moitié supérieure ; si elle est plus grande, elle écarte la moitié inférieure. Le processus se répète sur la portion restante. Pour retrouver un numéro dans un répertoire trié, cette réduction progressive est plus efficace qu’un examen ligne après ligne.
Une recherche rapide exige une structure adaptée
La recherche dichotomique repose sur une condition souvent oubliée : les éléments doivent être triés selon la même règle que celle utilisée pour la recherche. Chercher un nom dans une liste classée par date ne fonctionne pas avec cette méthode. Il faut aussi définir la manière de traiter les doublons. Un catalogue peut contenir plusieurs produits portant un nom proche, alors qu’un identifiant de commande devrait normalement être unique.
Pour une petite application, une liste suffit parfois. Quand les enregistrements deviennent nombreux, un index en base de données évite de parcourir chaque ligne. L’index joue le rôle d’un repère organisé, au prix d’un espace de stockage et d’un travail supplémentaire lors des mises à jour. C’est un arbitrage classique en production : obtenir une lecture plus rapide peut rendre les écritures plus coûteuses.
Du document scanné à l’information exploitable
La recherche dépend aussi de la qualité des données en entrée. Une facture numérisée sous forme d’image ne contient pas nécessairement du texte que le logiciel peut interroger. Un outil d’OCR extrait les caractères, puis un processus de nettoyage corrige les erreurs avant de permettre une recherche par numéro, date ou montant. Un exemple concret est détaillé dans ce dossier consacré à l’extraction de texte avec un OCR en ligne.
Supposons qu’un cabinet reçoive plusieurs centaines de reçus. La reconnaissance automatique peut récupérer les champs principaux, mais une lettre mal lue dans un identifiant peut rendre la recherche infructueuse. Il faut donc contrôler les cas à faible confiance, conserver le document source et suivre le taux d’erreur. Une recherche performante commence par des données correctement structurées et vérifiées.
Pour tester une méthode, mesurez le temps moyen de réponse, mais aussi les résultats manqués et les erreurs de correspondance. Dans un outil interne, quelques millisecondes gagnées n’ont aucun intérêt si les utilisateurs ne retrouvent plus leurs dossiers. Le bon indicateur dépend du travail réel, pas d’une démonstration technique isolée.
Algorithmes de recommandation : du comportement à une sélection pertinente
Un moteur de recommandation répond à une question différente : parmi une grande quantité de contenus, lesquels ont le plus de chances d’intéresser une personne ? Les exemples sont familiers : produits suggérés dans une boutique, vidéos proposées après un visionnage ou morceaux réunis dans une playlist. L’objectif n’est pas simplement de trouver une correspondance exacte, mais de hiérarchiser des options dans un contexte donné.
Les systèmes reposent souvent sur trois familles d’approches. Le filtrage basé sur le contenu compare les caractéristiques des éléments : genre d’un film, thème d’un article, prix d’un produit ou mots-clés d’une fiche. Le filtrage collaboratif s’appuie sur les comportements de plusieurs utilisateurs : des personnes ayant apprécié des contenus similaires peuvent recevoir des suggestions proches. Les méthodes hybrides combinent ces signaux avec des règles supplémentaires.
Le problème du démarrage à froid
Un nouvel utilisateur n’a pas encore d’historique. De même, un article publié depuis quelques minutes n’a reçu ni clic ni appréciation. Le moteur manque alors de signaux pour produire une recommandation personnalisée : c’est le démarrage à froid. Une solution consiste à utiliser des informations simples au départ, comme la catégorie choisie lors de l’inscription, la langue ou les contenus populaires auprès de profils comparables.
Une librairie numérique pourrait afficher d’abord les nouveautés d’un genre choisi, puis ajuster ses suggestions après les premières consultations. Il est prudent de garder une part de découvertes et de ne pas enfermer l’utilisateur dans ses derniers clics. Si chaque lecture d’un article sur le jardinage déclenche uniquement d’autres articles identiques, le système devient répétitif. La pertinence implique aussi une certaine diversité.
Mesurer autre chose que les clics
Un clic indique une réaction, pas nécessairement une satisfaction. Une recommandation sensationnelle peut attirer l’attention et décevoir ensuite. Pour une plateforme de cours, il est plus utile d’observer si la personne commence le module, le termine ou revient apprendre la semaine suivante. Les indicateurs doivent donc suivre l’objectif du service : engagement durable, découverte, conversion ou réduction du temps de recherche.
Le fil conducteur peut être une petite boutique de décoration. Elle commence avec des règles transparentes — afficher des articles de la même pièce et dans une gamme de prix comparable — puis teste un modèle collaboratif lorsque les données deviennent suffisantes. Elle compare les ajouts au panier et les achats, tout en surveillant les retours. Un moteur utile aide à choisir ; il ne transforme pas chaque interaction en vérité sur les goûts d’une personne.
Dans les usages avancés, la recommandation peut aussi soutenir des services moins évidents que le commerce ou le divertissement, par exemple en proposant des ressources de santé à partir de critères validés. Mais l’enjeu de responsabilité y est plus élevé : les règles de sélection doivent être compréhensibles, les données protégées et les décisions sensibles soumises à une supervision appropriée.
Architecture d’un moteur de recommandation : récupérer, classer, ajuster
Une grande plateforme ne peut généralement pas comparer chaque utilisateur à chaque élément disponible, puis calculer un classement complet en temps réel. Elle procède par étapes. D’abord, la récupération extrait un ensemble limité de candidats depuis un catalogue très vaste. Ensuite, le classement attribue un score à ces options. Enfin, un post-classement peut réordonner la liste pour respecter des contraintes de diversité, de fraîcheur ou de disponibilité.
| Étape | Rôle | Exemple concret |
|---|---|---|
| Récupération | Réduire le catalogue à des candidats plausibles | Repérer des produits proches des consultations récentes |
| Classement | Estimer l’intérêt de chaque candidat | Combiner pertinence, disponibilité et probabilité d’achat |
| Post-classement | Appliquer les contraintes finales | Éviter dix propositions presque identiques à la suite |
| Évaluation | Vérifier la qualité en conditions réelles | Comparer clics, achats, masquages et retours |
Des outils pour chaque étape
Dans l’écosystème TensorFlow, TensorFlow Recommenders aide à construire des modèles depuis la préparation des données jusqu’à l’expérimentation. Pour la recherche de candidats à grande échelle, une bibliothèque de recherche de similarité vectorielle comme ScaNN peut accélérer la récupération approximative de voisins proches. TensorFlow Ranking, lui, fournit des outils pour entraîner des modèles qui ordonnent les candidats selon différents objectifs.
Ces outils ne remplacent pas la conception du système. Une équipe doit décider quels événements collecter, comment traiter les données manquantes et à quelle fréquence recalculer les représentations. TensorFlow Serving peut servir les modèles entraînés dans une application, avec une attention particulière au débit et au temps de réponse. Un modèle puissant mais trop lent dégrade l’expérience, surtout sur une page où les recommandations doivent apparaître immédiatement.
Le choix de l’infrastructure dépend aussi des contraintes opérationnelles. Une petite entreprise n’a pas nécessairement besoin d’un système distribué ou d’accélérateurs spécialisés. Elle peut commencer par une sélection basée sur les catégories et les ventes, puis augmenter la sophistication lorsque le volume et le retour sur investissement le justifient. Cette logique rejoint les démarches de digitalisation des processus : cartographier le besoin avant d’empiler les outils.
Latence, qualité et déploiement progressif
Avant de mettre un moteur à disposition de tous, une équipe peut comparer ses recommandations à une règle de référence. Elle vérifie les résultats hors ligne sur des données historiques, puis lance un test contrôlé auprès d’une partie du trafic. Il faut suivre les erreurs techniques, les temps de réponse et les réactions des utilisateurs. Une amélioration moyenne peut masquer une forte dégradation pour un segment précis.
Un système en plusieurs étapes permet justement d’équilibrer vitesse et pertinence. La récupération rapide écarte l’immense majorité des éléments, puis le classement plus coûteux travaille seulement sur une petite sélection. En production, l’architecture compte autant que le modèle : la meilleure recommandation est inutile si elle arrive trop tard.
Construire un algorithme fiable : données, biais et amélioration continue
La performance d’un algorithme dépend d’abord de la qualité des informations qu’on lui fournit. Des clics peuvent être générés par curiosité, une campagne publicitaire ou une interface trompeuse. Les traiter comme des preuves directes d’intérêt risque de fausser les recommandations. Il est préférable de distinguer les événements : impression, clic, achat, retour produit, avis ou masquage n’ont ni le même sens ni la même valeur.
Les biais apparaissent lorsque les données historiques reflètent une exposition inégale. Si les produits déjà populaires sont davantage affichés, ils obtiennent plus de clics, ce qui renforce encore leur visibilité. Les nouveautés et les petits vendeurs peuvent devenir presque invisibles. Des mécanismes de diversité, des règles de rotation ou une part d’exploration contrôlée aident à limiter ce cercle, sans garantir à eux seuls un classement équitable.
Explorer sans sacrifier les résultats immédiats
Les approches de type bandit équilibrent deux besoins : proposer des éléments déjà appréciés et essayer des options moins connues pour apprendre. Une boutique peut, par exemple, réserver une faible proportion des emplacements à des articles nouveaux mais pertinents. Si les réactions sont bonnes, le système dispose d’un signal supplémentaire ; si elles sont faibles, l’exposition reste limitée.
Cette exploration doit être conçue avec prudence. Une recommandation n’est pas un test neutre si elle concerne une décision financière, médicale ou une information susceptible d’influencer fortement l’utilisateur. Les règles de sécurité, la possibilité de masquer certaines suggestions et la surveillance des résultats font partie du produit. Le modèle ne porte pas seul la responsabilité des décisions prises autour de lui.
Protéger les données et garder une solution explicable
La personnalisation peut s’appuyer sur des données sensibles ou identifiantes. Il faut collecter uniquement ce qui sert réellement, définir une durée de conservation et restreindre les accès. Certaines recommandations peuvent être calculées directement sur l’appareil, ce qui réduit les transferts de données. L’apprentissage fédéré permet, dans certaines architectures, d’entraîner des modèles à partir de calculs réalisés sur des appareils sans centraliser de la même façon les données brutes.
Une entreprise peut aussi prévoir une explication simple : « suggéré parce que vous consultez cette catégorie » est plus compréhensible qu’un score opaque. Cette explication n’a pas besoin de révéler tous les détails techniques, mais elle doit correspondre au fonctionnement réel. Les équipes peuvent ensuite suivre les performances par type d’utilisateur, contrôler les écarts et recueillir des retours qualitatifs.
Pour démarrer, un plan pragmatique suffit :
- Définir l’objectif : préciser si le système doit faciliter la découverte, augmenter les ventes ou réduire le temps de recherche.
- Choisir les signaux utiles : séparer les consultations, les clics, les achats et les retours plutôt que de les mélanger.
- Établir une référence : comparer le modèle à une règle simple et compréhensible.
- Tester progressivement : mesurer les effets sur un groupe limité avant un déploiement complet.
- Surveiller dans le temps : vérifier les biais, la latence, la qualité des données et les changements de comportement.
Les modèles modernes peuvent intégrer des graphes, des représentations vectorielles, des bandits ou des modèles de langage pour mieux comprendre le contexte. Ces briques ne sont pertinentes que si elles répondent à un besoin observé et si leur coût reste maîtrisé. La méthode la plus efficace est souvent celle que l’équipe peut mesurer, expliquer et améliorer sans perdre de vue l’utilisateur.
Quelle est la différence entre un algorithme et une intelligence artificielle ?
Un algorithme est une suite d’instructions conçue pour résoudre un problème. L’intelligence artificielle regroupe notamment des méthodes qui apprennent à partir de données ; un système d’IA utilise lui aussi des algorithmes, mais tous les algorithmes ne relèvent pas de l’IA.
Quel algorithme de tri choisir pour une petite liste ?
Pour comprendre le principe, le tri par insertion ou le tri par sélection sont faciles à suivre. Dans une application réelle, les fonctions de tri intégrées au langage sont généralement préférables, sauf besoin spécifique clairement identifié.
Comment fonctionne un moteur de recommandation ?
Il récupère d’abord des éléments candidats, les classe selon leur pertinence estimée, puis peut ajuster l’ordre pour respecter des contraintes comme la diversité ou la disponibilité. Les signaux utilisés dépendent du service et de son objectif.
Faut-il beaucoup de données pour commencer ?
Pas nécessairement. Des règles basées sur les catégories, les préférences déclarées ou les éléments populaires permettent de créer une première version. Les données comportementales deviennent utiles ensuite, à condition d’être correctement collectées et interprétées.