En bref
-
Un algorithme est une méthode composée d’instructions précises qui transforme des données de départ en résultat.
-
Il ne se confond pas avec un programme : l’algorithme décrit la logique, tandis que le code permet de l’exécuter sur une machine.
-
GPS, moteurs de recherche, paiements et recommandations reposent sur des méthodes algorithmiques différentes.
-
Un système automatisé n’est pas automatiquement neutre : les données et les objectifs choisis influencent ses résultats.
-
Pour concevoir une méthode fiable, il faut la décrire, la tester sur des cas variés et mesurer son efficacité.
Un algorithme n’est pas une formule magique réservée aux informaticiens. C’est une suite d’étapes organisées pour résoudre un problème : préparer un repas, calculer un itinéraire, classer des fichiers ou repérer un paiement inhabituel. Dès qu’une tâche peut être décrite avec des consignes assez claires pour être répétées, une méthode algorithmique peut aider à l’exécuter.
Dans le monde numérique, ces méthodes traitent des données à une vitesse difficile à égaler manuellement. Elles contribuent à afficher des résultats de recherche, à proposer une vidéo ou à organiser la circulation d’informations dans une entreprise. Pour comprendre leur rôle, inutile de commencer par le code : le plus utile est d’observer ce qu’elles reçoivent, les règles qu’elles appliquent et le résultat qu’elles produisent. C’est là que le mot devient concret.
Algorithme : une définition simple pour comprendre son fonctionnement
Un algorithme est une suite finie et ordonnée d’instructions qui permet de traiter des données d’entrée afin d’obtenir un résultat. Chaque étape doit être suffisamment précise pour que la méthode puisse être suivie sans deviner ce qu’il faut faire. Elle peut être exécutée par une personne, une calculatrice ou un ordinateur : l’idée reste la même, même si l’exécutant change.
La recette de cuisine est une comparaison parlante. Pour faire une pâte, il faut réunir des ingrédients, les mélanger dans un ordre donné, puis respecter une durée et une température de cuisson. Une consigne comme « cuire jusqu’à ce que ce soit prêt » manque de précision ; « cuire vingt minutes à 180 degrés » est plus facile à appliquer et à reproduire. Un algorithme utile doit, lui aussi, réduire les zones floues.
Entrées, traitement et résultat : le fil logique
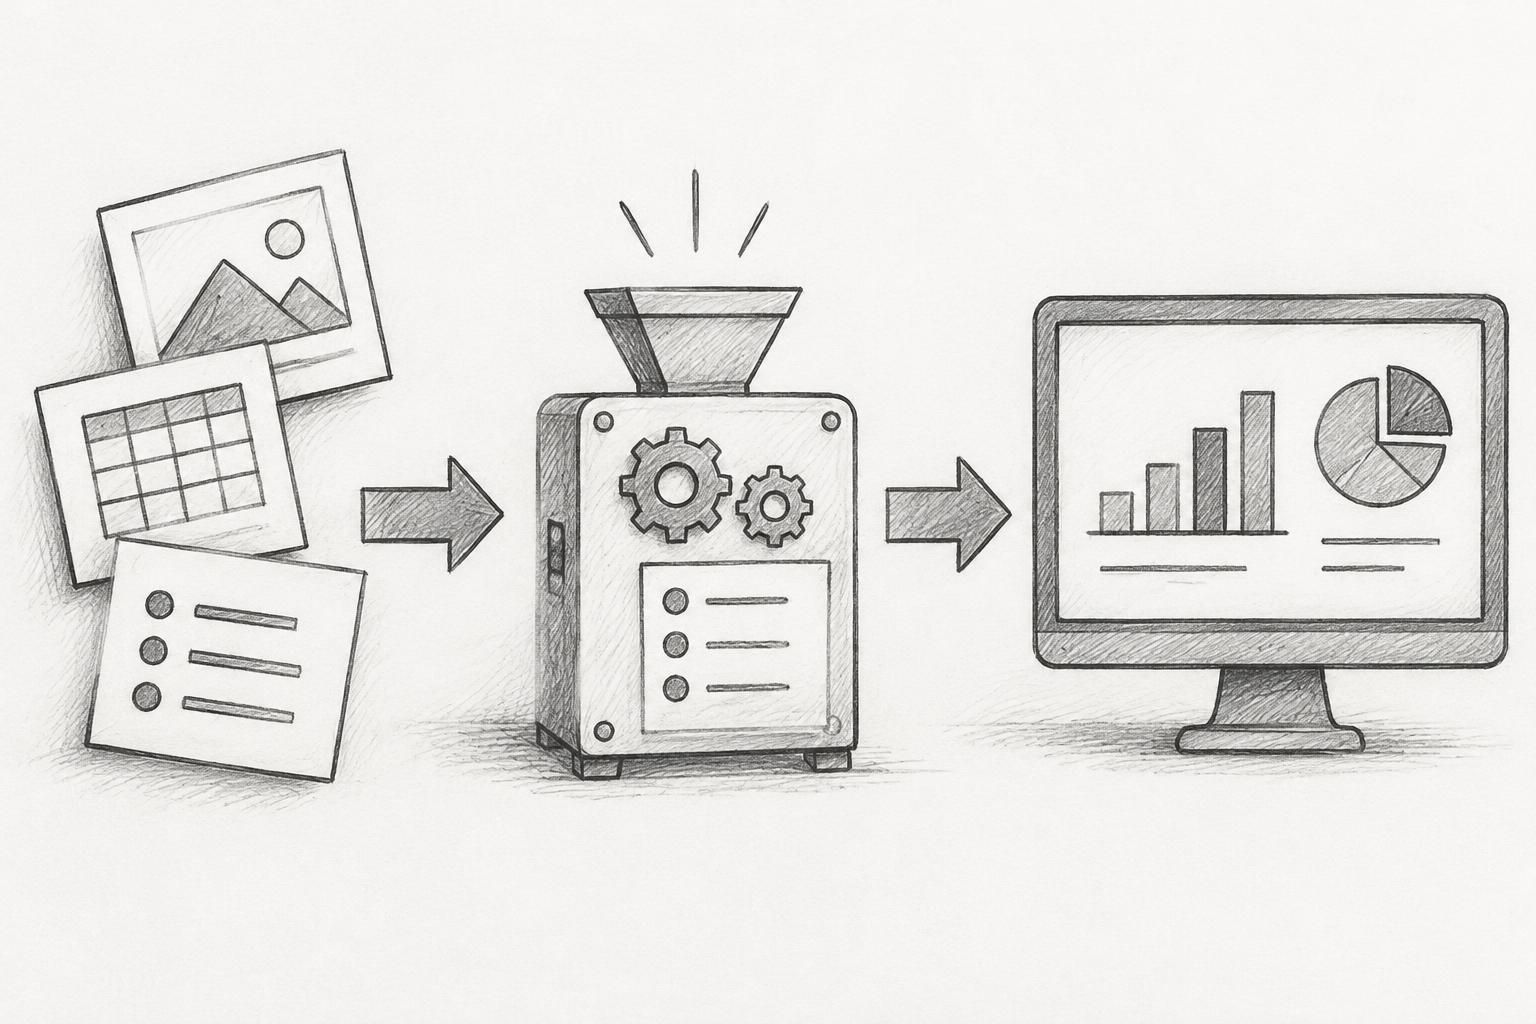
La plupart des méthodes suivent trois grandes étapes. Elles reçoivent d’abord des données d’entrée, appliquent ensuite un traitement — calcul, comparaison, classement ou décision — puis fournissent une sortie exploitable. Cette structure aide à comprendre un outil numérique sans avoir à lire son code source.
Imaginons Maya, qui développe un service de mobilité. Son système reçoit la position de départ, la destination et des informations sur la circulation. Il compare plusieurs itinéraires, estime leur durée, puis propose le trajet jugé le plus adapté selon le critère retenu. Si le trafic évolue, de nouvelles données peuvent alimenter un nouveau calcul. La logique devient visible : données, règles, réponse.
La méthode est indépendante du langage informatique. Un algorithme de calcul de taxe peut être décrit en français, en pseudo-code ou dans un organigramme, puis programmé en Python, JavaScript ou un autre langage. Le code traduit les consignes dans une forme que l’ordinateur peut exécuter ; il n’est pas, à lui seul, l’idée algorithmique.
Une méthode doit pouvoir s’arrêter
La finitude est un repère essentiel : une procédure doit aboutir, et ne pas tourner sans fin dans une boucle. Elle doit aussi être exécutable, c’est-à-dire composée d’opérations réalisables. Enfin, ses choix doivent être suffisamment définis pour que chaque situation prévue mène à une étape identifiable.
Une méthode de recherche dans une liste, par exemple, peut examiner les éléments un par un et s’arrêter lorsqu’elle trouve celui qui est demandé ou lorsqu’elle a parcouru toute la liste. Sans condition d’arrêt, elle continuerait à chercher même après avoir atteint la fin. Une définition claire commence donc par une question simple : quelles informations entrent, quelles opérations sont appliquées, et à quel moment le processus s’arrête-t-il ?
Exemples d’algorithmes du quotidien : du GPS aux recherches web
Les algorithmes sont souvent invisibles parce qu’ils se fondent dans des services ordinaires. Leur présence se remarque surtout lorsqu’un outil répond vite à une demande complexe : trouver un trajet, trier des milliers de fichiers ou afficher des contenus susceptibles d’intéresser une personne. Dans chaque cas, une méthode transforme des informations en une réponse adaptée à un objectif donné.
Un GPS illustre bien cette mécanique. Il utilise une carte composée de routes et de points de connexion, puis compare différents chemins entre une origine et une destination. Selon le service, il peut prendre en compte la distance, les limitations, les travaux ou les conditions de circulation. Le « meilleur » trajet dépend donc du critère choisi : le plus court en kilomètres n’est pas toujours le plus rapide.
Classer, chercher et recommander
Un moteur de recherche reçoit une requête et doit repérer, parmi une très grande quantité de pages, celles qui semblent répondre au besoin. Des systèmes analysent notamment le contenu, le contexte de la recherche et différents signaux de qualité. Ils organisent ensuite les résultats selon une estimation de pertinence. Cette organisation n’est pas une vérité absolue : elle dépend des données accessibles et des règles de classement.
Dans une boutique en ligne, une méthode de recommandation peut rapprocher des produits consultés, des achats antérieurs et des comportements de personnes ayant des intérêts similaires. Si une cliente achète une cafetière, le site peut lui suggérer des filtres compatibles. Cette suggestion repose sur un objectif commercial autant que sur une estimation de pertinence : l’algorithme contribue à orienter l’attention et la conversion.
Le tri de fichiers est plus simple à visualiser. Il peut classer des documents par date, nom ou taille, en appliquant une règle définie à chaque élément. Dans une entreprise, des outils de gestion documentaire permettent de retrouver plus vite les bons dossiers ; le choix d’un logiciel de gestion électronique des documents dépend justement des besoins de classement, de recherche et de circulation de l’information.
Automatiser une tâche répétitive sans perdre le contrôle
Les algorithmes servent aussi à automatiser des opérations administratives. Un système de traitement de factures peut repérer un montant, une date et le nom d’un fournisseur, puis transférer ces informations vers un logiciel de gestion. La reconnaissance optique de caractères, ou OCR, facilite cette extraction, mais une vérification humaine peut rester nécessaire lorsque le document est flou ou mal structuré. Un outil d’OCR pour extraire du texte illustre cette chaîne : image reçue, caractères identifiés, données réutilisables.
La même logique se retrouve dans les paiements. Des règles peuvent signaler une transaction inhabituelle en fonction de son montant, de sa localisation ou de sa fréquence. Une alerte ne prouve pas qu’il y a fraude ; elle désigne un cas à examiner. C’est une différence importante entre automatiser une tâche et déléguer entièrement une décision.
Pour une petite entreprise, la question pratique n’est pas seulement « peut-on automatiser ? », mais « quelle étape mérite de l’être ? ». Une automatisation utile réduit les tâches répétitives sans masquer les erreurs ni rendre le processus incompréhensible. Un algorithme crée de la valeur lorsqu’il transforme une opération précise en résultat vérifiable.
Types d’algorithmes : règles classiques et apprentissage automatique
Tous les algorithmes ne fonctionnent pas de la même manière. Certains suivent des règles écrites à l’avance : si une condition est remplie, une action précise est réalisée. D’autres sont conçus pour repérer des régularités dans des exemples et produire des estimations à partir de ce qu’ils ont appris. Cette distinction aide à comprendre pourquoi deux outils numériques peuvent donner des réponses différentes face à une même situation.
Un calcul de TVA est un exemple classique. Le taux est connu, la base de calcul est fournie, et le résultat découle d’une opération définie. Avec les mêmes données, le système rend normalement le même résultat. Le traitement est reproductible et facile à vérifier, ce qui est précieux pour des tâches comptables ou des contrôles simples.
Des instructions explicites ou des régularités apprises
Dans l’apprentissage automatique, le développeur ne rédige pas nécessairement une règle détaillée pour chaque cas. Il fournit plutôt des exemples et une méthode d’entraînement qui permet au système de repérer des relations statistiques. Un outil entraîné sur des images peut ainsi apprendre à distinguer certains objets, sans qu’une personne ait décrit une à une toutes leurs formes possibles.
Cette capacité a une contrepartie. Une prédiction dépend de la qualité et de la diversité des exemples utilisés. Si les données représentent mal certaines situations, les résultats peuvent être moins fiables pour les personnes concernées. Un système qui apprend des régularités n’accède pas à une compréhension humaine : il calcule une réponse à partir de modèles présents dans les données.
| Critère | Algorithme à règles explicites | Apprentissage automatique |
|---|---|---|
| Origine du fonctionnement | Consignes écrites directement par des concepteurs | Relations estimées à partir d’exemples |
| Résultat fréquent | Stable si les entrées et les règles sont identiques | Souvent une estimation ou une probabilité |
| Exemple | Calculer un total avec un taux défini | Classer une image ou détecter une anomalie |
| Point de vigilance | Règles trop rigides face aux cas imprévus | Données biaisées ou représentatives de façon incomplète |
Plusieurs familles pour des problèmes différents
Les algorithmes de tri organisent des éléments selon un critère, tandis que les algorithmes de recherche tentent de trouver une information dans une collection. Les algorithmes de chiffrement servent à protéger des données en les rendant illisibles sans la clé appropriée. Les méthodes d’optimisation, elles, comparent des options afin de réduire un coût, une durée ou une distance.
Dans une entreprise de livraison fictive, Maya pourrait utiliser une méthode de recherche pour retrouver une commande, un calcul d’itinéraire pour organiser les tournées et un modèle statistique pour estimer les volumes à venir. Ces outils ne remplacent pas une stratégie opérationnelle : ils la mettent en œuvre à partir de critères choisis. Si l’objectif consiste à réduire les kilomètres sans tenir compte des horaires de livraison, le résultat peut être techniquement cohérent et pourtant inutilisable.
Le mot « intelligent » ne suffit donc pas à choisir une solution. Il faut préciser le problème, les données disponibles et la conséquence d’une erreur. Pour un calcul réglementaire, la traçabilité et la reproductibilité peuvent primer ; pour une recommandation, une estimation pertinente peut être acceptable si elle est suivie et corrigée. La bonne famille d’algorithmes est celle qui répond au besoin réel, pas celle dont le nom paraît le plus moderne.
Comment concevoir un algorithme fiable avant de programmer
Écrire du code trop tôt est une source classique de retours en arrière. Avant de choisir un langage ou un outil, il est plus efficace de formuler le problème en termes simples : quelle tâche doit être réalisée, quelles informations sont nécessaires et quel résultat permettra de vérifier que le système fonctionne ? Cette étape évite de construire une automatisation élégante autour d’un besoin mal défini.
Pour le service de mobilité de Maya, le problème pourrait être formulé ainsi : « proposer un trajet entre deux lieux en minimisant le temps estimé, tout en respectant les contraintes de circulation connues ». Cette phrase rend visibles les entrées, l’objectif et les limites. Si l’entreprise souhaite plutôt réduire la consommation de carburant, le critère change et le choix du trajet peut aussi changer.
Décrire la méthode en pseudo-code
Le pseudo-code permet de représenter les étapes sans respecter la syntaxe d’un langage informatique. Il sert de brouillon logique et facilite les échanges entre les personnes qui définissent le besoin et celles qui développent le programme. Par exemple : recevoir le départ et l’arrivée, lister les itinéraires possibles, estimer la durée de chacun, écarter ceux qui ne respectent pas les contraintes, puis afficher le meilleur résultat.
Cette description fait ressortir des questions utiles. Que se passe-t-il si aucune route n’est disponible ? Comment traiter une adresse inconnue ? À quel moment actualiser les informations de trafic ? Les cas limites sont souvent à l’origine des bugs les plus gênants, car ils apparaissent rarement dans une démonstration préparée avec des données parfaites.
Tester, mesurer et améliorer
Les tests doivent couvrir plusieurs situations : une requête habituelle, une donnée manquante, une valeur extrême et une entrée invalide. Pour une méthode de tri, on peut tester une liste vide, un seul élément, des doublons et une liste déjà ordonnée. Le but n’est pas de prouver que tout fonctionnera dans toutes les circonstances, mais de repérer tôt les erreurs prévisibles.
Il faut ensuite mesurer les ressources consommées. Une méthode peut donner le bon résultat sur dix éléments, mais devenir trop lente sur un million. Le temps de calcul et la mémoire utilisée deviennent alors des critères de conception, surtout lorsqu’un service traite de nombreuses demandes en parallèle. Optimiser n’a de sens qu’après avoir confirmé que le résultat est correct : accélérer une logique erronée revient simplement à produire des erreurs plus vite.
Dans un processus de gestion documentaire, par exemple, une séquence automatisée peut recevoir un fichier, reconnaître son type, extraire des champs, puis le transmettre à la bonne équipe. La digitalisation des processus industriels suit une logique comparable : cartographier les étapes, automatiser celles qui sont répétitives et prévoir une intervention lorsque les données sont insuffisantes.
Une fois la méthode validée, elle peut être traduite dans un programme et documentée. La documentation précise les hypothèses retenues, les règles appliquées et les limites connues. Cette trace devient précieuse lorsque l’équipe évolue ou que le processus doit être audité. Concevoir, c’est rendre la logique testable avant de la rendre automatique.
Limites des algorithmes : biais, transparence et décisions automatisées
Un algorithme peut appliquer ses règles avec constance sans être juste pour autant. Il dépend des objectifs définis par ses concepteurs, des données qu’il reçoit et de la façon dont les résultats sont utilisés. Une méthode de recommandation optimisée pour prolonger le temps passé sur une plateforme ne poursuit pas le même objectif qu’un outil conçu pour diversifier les sources d’information. La question « que fait-il ? » doit donc être complétée par « dans quel but ? ».
Les biais peuvent apparaître à plusieurs étapes. Des données historiques peuvent refléter des inégalités déjà présentes ; des informations manquantes peuvent pénaliser certains profils ; un indicateur mal choisi peut encourager un comportement indésirable. Un système de recrutement, par exemple, qui apprend à partir de décisions passées risque de reproduire des préférences anciennes au lieu d’évaluer équitablement les compétences.
Un résultat automatisé mérite parfois une vérification humaine
Dans les services de contenu, une recommandation est une sélection, pas un reflet neutre de tout ce qui existe. Dans un outil de détection de fraude, une alerte signale un risque à examiner plutôt qu’une preuve définitive. Distinguer suggestion, estimation et décision est indispensable pour éviter de donner à une sortie calculée une autorité qu’elle ne possède pas.
La transparence joue aussi un rôle pratique. Une équipe doit pouvoir savoir quelles données sont utilisées, quelle règle influence la décision et comment signaler une erreur. Cette exigence est particulièrement importante lorsque les résultats ont des conséquences sur l’accès à un service, une transaction ou une opportunité professionnelle. Les démarches d’IA éthique et d’innovation responsable cherchent justement à relier performance, contrôle et prise en compte des effets humains.
Protéger les données et conserver une capacité d’action
Un algorithme ne fonctionne pas dans le vide : il s’appuie souvent sur des données personnelles ou commerciales. Il faut donc limiter les informations collectées à ce qui est utile, encadrer leur accès et prévoir leur durée de conservation. Les utilisateurs gagnent également à comprendre les réglages de personnalisation, à diversifier leurs sources et à vérifier les informations importantes plutôt que de suivre automatiquement la première suggestion affichée.
Dans une entreprise, l’automatisation doit être examinée avec la même prudence. Un outil non validé peut traiter des documents sensibles ou créer des dépendances difficiles à gérer. Un processus fiable indique qui contrôle les résultats, comment les erreurs sont corrigées et quelle solution prend le relais en cas de panne. L’innovation utile n’est pas celle qui supprime toute intervention humaine, mais celle qui permet de consacrer le temps humain aux décisions où le jugement compte vraiment.
Pour Maya, le lancement du calcul d’itinéraires ne se limite donc pas à afficher le trajet le plus rapide. Il faut vérifier la fraîcheur des données, signaler les estimations incertaines et permettre aux utilisateurs de choisir d’autres critères. Cette approche rend le service plus compréhensible et évite de transformer un calcul en consigne aveugle. Un algorithme aide à décider ; la responsabilité de définir les objectifs et de contrôler les effets reste humaine.
Qu’est-ce qu’un algorithme, en termes simples ?
C’est une suite finie et ordonnée d’instructions qui traite des données d’entrée pour produire un résultat. Une recette précise ou un calcul d’itinéraire en sont des exemples.
Quelle différence entre un algorithme et un programme ?
L’algorithme décrit la méthode à suivre. Le programme est sa traduction dans un langage informatique afin qu’un ordinateur puisse l’exécuter. Une même méthode peut être programmée dans plusieurs langages.
Tous les algorithmes donnent-ils toujours le même résultat ?
Les méthodes déterministes produisent le même résultat avec les mêmes entrées et les mêmes règles. Certains systèmes d’apprentissage automatique fournissent plutôt des estimations ou des résultats probabilistes.
Comment apprendre à concevoir un algorithme ?
Commencez par définir un problème simple, notez les données nécessaires et décrivez les étapes en pseudo-code. Testez ensuite les cas habituels et les cas limites avant de programmer et d’optimiser la méthode.