Le machine learning et le deep learning sont deux approches majeures de l’intelligence artificielle, mais elles ne désignent pas la même chose. Le premier regroupe des méthodes qui apprennent à partir d’exemples ; le second en est une famille spécialisée, fondée sur des réseaux de neurones profonds. Cette distinction change le type de données à prévoir, les compétences nécessaires, le coût de calcul et la façon d’évaluer un projet.
Pour une entreprise, la question n’est donc pas de choisir la technologie la plus impressionnante. Il faut d’abord comprendre le problème à résoudre : prévoir une demande, classer des factures, repérer une fraude ou analyser du texte. Un modèle simple, bien alimenté et correctement contrôlé peut faire mieux qu’un réseau complexe lancé trop tôt. Voici les repères pour distinguer les approches et choisir celle qui sert réellement votre activité.
En bref
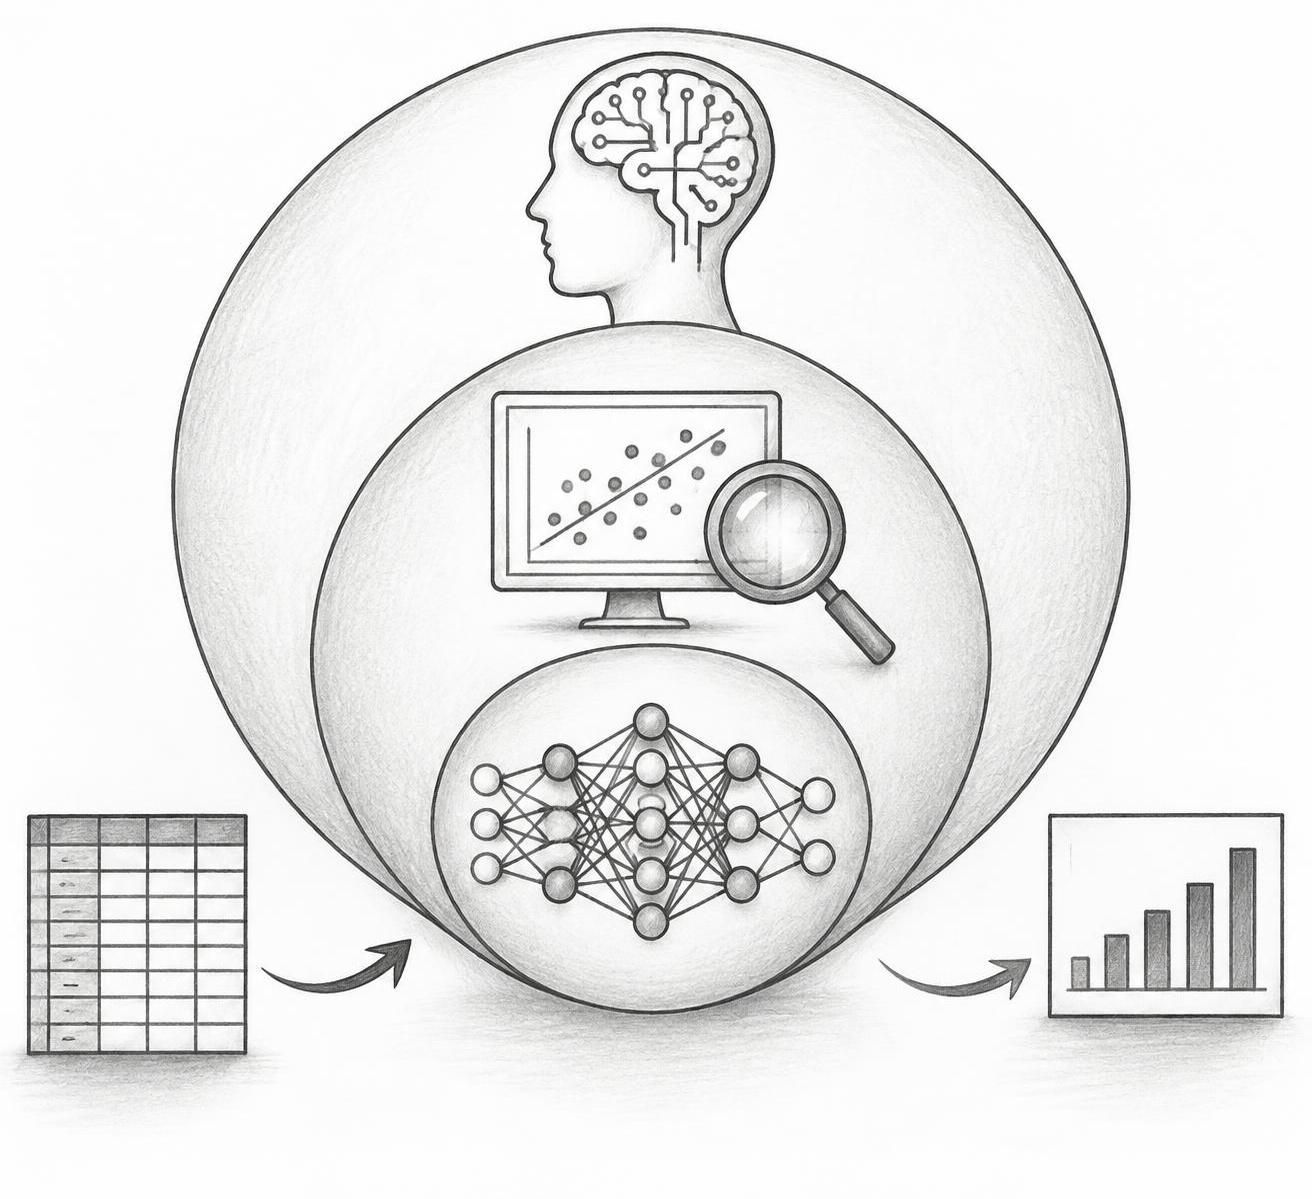
- L’intelligence artificielle est le domaine général ; le machine learning en est une branche et le deep learning une spécialisation du machine learning.
- Le machine learning convient souvent aux données tabulaires et aux prédictions ciblées, avec des besoins de calcul modérés.
- Le deep learning apprend des représentations complexes à partir de texte, d’images, de sons ou de vidéos, mais réclame davantage de données et de ressources.
- La qualité des données, le coût d’exploitation et la capacité à expliquer les résultats comptent autant que la précision du modèle.
- Pour un projet documentaire, l’OCR peut lire les fichiers, tandis que des modèles d’apprentissage extraient, classent ou contrôlent les informations.
Machine learning : définition, fonctionnement et place dans l’intelligence artificielle
L’intelligence artificielle désigne un vaste ensemble de techniques permettant à un système d’accomplir certaines tâches associées à des capacités humaines : analyser une situation, reconnaître un motif, produire une réponse ou aider à prendre une décision. Tout système d’IA n’apprend pas nécessairement à partir de données. Un programme fondé sur des règles écrites explicitement peut, lui aussi, relever de l’IA au sens large.
Le machine learning, ou apprentissage automatique, est une branche de ce domaine. Au lieu de programmer chaque décision une par une, on fournit au modèle des exemples afin qu’il repère des régularités. Il ajuste ensuite ses paramètres pour produire une prédiction sur des données qu’il n’a pas encore rencontrées. Cette démarche n’élimine pas le travail humain : il faut choisir les données, définir la cible, vérifier les erreurs et organiser le suivi.
Des exemples pour apprendre, pas une suite de consignes figées
Imaginez une boutique en ligne qui veut anticiper les retours de produits. Une équipe peut réunir des commandes passées, les catégories d’articles, les délais de livraison et les retours observés. Un algorithme apprend alors quelles combinaisons sont associées à un risque plus élevé. Il ne « comprend » pas nécessairement pourquoi un client renvoie un article ; il estime une probabilité à partir des exemples fournis.
Le choix de ce que l’on présente au modèle compte énormément. Si les historiques ne couvrent que certaines catégories de clients, les prédictions risquent d’être moins fiables pour les autres. Si la définition d’un « retour problématique » change au fil du temps, le système peut aussi apprendre une règle devenue obsolète. Un modèle efficace commence donc par une question métier précise et des données représentatives, pas par la recherche d’un algorithme à la mode.
Classification, régression et regroupement
Les usages classiques du machine learning se répartissent souvent en plusieurs familles. La classification attribue une catégorie, par exemple « spam » ou « courrier légitime ». La régression estime une valeur numérique, comme le volume de ventes attendu la semaine suivante. Le regroupement, lui, cherche des profils similaires sans disposer au départ d’étiquettes déjà définies.
Ces méthodes interviennent dans le filtrage des courriels, la détection de transactions inhabituelles, la prévision de stocks ou la segmentation de clients. Un système de recommandation peut également analyser les interactions pour proposer des contenus ou des produits susceptibles d’intéresser une personne. Pour comprendre la logique de ces systèmes, consultez cet aperçu des algorithmes de recommandation.
Le machine learning ne se limite pas aux tableaux de chiffres. Il peut traiter du texte ou d’autres données, mais le traitement peut demander une représentation adaptée et une préparation importante. Dans une approche traditionnelle, des spécialistes définissent parfois des variables utiles — fréquence d’un mot, montant moyen d’achat, nombre de connexions — avant l’entraînement. Cette étape, appelée ingénierie des caractéristiques, influence fortement le résultat.
Un modèle n’est pas une vérité gravée dans le code. Il produit une estimation qui doit être comparée aux résultats réels, puis surveillée lorsque les usages évoluent. Pour une petite équipe, c’est souvent une bonne nouvelle : un modèle classique bien mesuré peut tourner sur des ressources standard et se révéler plus facile à expliquer. Le bon point de départ est le problème métier, pas la complexité de la technique.
Deep learning : réseaux de neurones, données et apprentissage profond
Le deep learning, ou apprentissage profond, est une sous-catégorie du machine learning. Il s’appuie sur des réseaux de neurones artificiels composés de couches successives. Une première couche reçoit les données ; des couches intermédiaires en apprennent des représentations ; une dernière couche produit une sortie, par exemple une catégorie, une transcription ou une estimation.
La comparaison avec le cerveau humain aide à visualiser l’idée générale, mais elle ne doit pas être prise au pied de la lettre. Un réseau de neurones artificiels est un système mathématique entraîné à ajuster des paramètres. Sa performance dépend de son architecture, de la qualité des exemples, de la fonction d’apprentissage et des ressources de calcul disponibles. Il ne raisonne pas comme une personne simplement parce que son nom évoque des neurones.
Apprendre des caractéristiques à partir de données brutes
Dans une tâche de reconnaissance d’image, un modèle classique pourrait nécessiter que l’on définisse manuellement des indicateurs utiles. Un réseau profond peut apprendre des représentations à plusieurs niveaux : motifs simples, contours, textures, puis assemblages plus complexes. Pour analyser la parole, il peut également apprendre à relier des signaux audio à des sons, des mots et des structures de langage.
Cette capacité est précieuse avec des données dites non structurées : images, audio, vidéo ou texte libre. Elle contribue aux systèmes de transcription vocale, de traduction automatique, de vision par ordinateur et aux assistants capables de traiter plusieurs types de contenus. Les modèles génératifs de texte et d’image reposent eux aussi sur des architectures de deep learning, même si les systèmes actuels réunissent souvent plusieurs composants et étapes de traitement.
La promesse a toutefois son revers. Ces modèles peuvent nécessiter beaucoup d’exemples, du matériel spécialisé et un temps d’entraînement important. Le coût ne s’arrête pas à la phase de création : chaque requête peut consommer des ressources, et le système doit être surveillé pour repérer les erreurs, les dérives et les changements dans les données. Pour un usage à faible volume, un modèle profond peut donc être disproportionné.
Pourquoi les données et le contrôle restent décisifs
Un grand volume de données ne garantit pas automatiquement un bon résultat. Des images mal cadrées, des textes issus d’une seule source ou des étiquettes incohérentes peuvent pousser le modèle dans une mauvaise direction. Il peut aussi mémoriser les exemples d’entraînement sans réussir sur de nouveaux cas : c’est le surapprentissage. L’évaluation doit donc inclure des données distinctes de celles utilisées pour entraîner le système.
Le deep learning est parfois décrit comme autonome, parce qu’il apprend lui-même des caractéristiques utiles. En pratique, il exige toujours une intervention : sélection des données, choix des objectifs, contrôle des réponses et validation dans le contexte réel. Pour détecter une fraude, par exemple, une alerte automatisée ne devrait pas être confondue avec une preuve. Une équipe doit pouvoir vérifier les cas sensibles et mesurer les faux positifs, faute de quoi les contrôles peuvent ralentir des opérations légitimes.
Les réseaux profonds sont aussi moins faciles à interpréter que certains modèles classiques. Une entreprise qui traite des dossiers financiers, médicaux ou administratifs doit savoir quelles explications fournir, quelles données protéger et qui peut contester une décision. La performance brute n’est qu’un indicateur parmi d’autres. Le deep learning devient pertinent quand la complexité des données justifie réellement son coût et son niveau de contrôle.
Machine learning ou deep learning : les différences qui changent un projet
Les deux approches apprennent à partir de données et visent à généraliser au-delà des exemples observés. La différence se trouve surtout dans la façon dont elles construisent cette généralisation, les types de problèmes où elles excellent et les moyens qu’elles mobilisent. Il serait toutefois trompeur d’affirmer que le machine learning ne traite que des données structurées ou que le deep learning est automatiquement plus précis. Le contexte et la qualité de la mise en œuvre restent déterminants.
| Critère | Machine learning classique | Deep learning |
|---|---|---|
| Approche | Algorithmes variés, parfois fondés sur des caractéristiques préparées à l’avance | Réseaux de neurones à plusieurs couches qui apprennent des représentations complexes |
| Données souvent adaptées | Tableaux, historiques de ventes, indicateurs et variables métier | Images, sons, textes et grands ensembles multimodaux |
| Préparation | Ingénierie des caractéristiques souvent importante | Apprentissage plus automatique des caractéristiques, mais préparation et contrôle toujours nécessaires |
| Ressources | Souvent compatible avec des machines standard et des jeux de données modérés | Calcul et mémoire plus importants, notamment pour l’entraînement à grande échelle |
| Interprétation | Certains modèles produisent des règles ou des variables explicatives lisibles | Explication souvent plus difficile, selon l’architecture et les outils de contrôle |
| Exemples d’usage | Prévision de ventes, scoring, classification de clients et anomalies tabulaires | Reconnaissance vocale, vision, analyse de texte et génération de contenu |
Un cas concret : prévoir le stock d’une boutique
Une petite boutique de décoration veut estimer les ventes de ses produits le mois prochain. Elle dispose de plusieurs années de commandes, de prix, de périodes promotionnelles et de délais de livraison. Un modèle de régression ou un arbre de décision peut exploiter ces colonnes et produire des estimations utiles, sans nécessiter des millions d’exemples ni un parc de processeurs graphiques.
Le travail principal se situe alors dans la fiabilité des historiques : les ruptures doivent être distinguées d’une absence de demande, les promotions correctement signalées et les catégories de produits cohérentes. Un modèle profond n’apportera pas forcément de valeur supplémentaire si les données sont déjà structurées et si le besoin consiste à prédire une quantité. Le temps gagné grâce à une solution plus simple peut être investi dans la qualité des données ou l’intégration au système de stock.
Un autre cas : comprendre des documents numérisés
La situation change lorsqu’une entreprise reçoit des factures, des contrats et des pièces justificatives sous des formats variés. L’OCR, ou reconnaissance optique de caractères, transforme l’image en texte exploitable. Des modèles peuvent ensuite repérer les montants, les dates, les noms de fournisseurs ou les anomalies. Un document bien cadré et uniforme peut être traité avec des règles relativement simples ; des scans hétérogènes, des mises en page changeantes ou des écritures manuscrites rendent la tâche plus complexe.
Le système doit être évalué sur les erreurs qui ont un impact réel. Confondre deux chiffres dans un montant, omettre une page ou attribuer une facture au mauvais fournisseur ne représente pas le même risque qu’une petite variation de mise en forme. Une solution fiable prévoit donc un seuil de confiance, une vérification humaine pour les cas incertains et une trace des corrections. La reconnaissance seule ne suffit pas à rendre un processus sûr.
Dans les deux exemples, le choix ne découle pas d’une hiérarchie où le deep learning serait toujours supérieur. Il découle de la nature du problème, du volume d’exemples disponibles, du coût acceptable et de la conséquence d’une erreur. La meilleure technologie est celle qui atteint le niveau de qualité utile sans créer une infrastructure inutilement lourde.
Types d’apprentissage et données : ce que le modèle apprend vraiment
Machine learning et deep learning ne décrivent pas à eux seuls la façon dont un modèle apprend. Il faut également regarder le type d’apprentissage, c’est-à-dire la manière dont les exemples sont présentés et le signal utilisé pour ajuster le système. Cette distinction aide à comprendre pourquoi deux projets utilisant des réseaux de neurones peuvent suivre des démarches très différentes.
Apprentissage supervisé et non supervisé
En apprentissage supervisé, les exemples sont associés à une réponse attendue. Pour entraîner un filtre antispam, on fournit des courriels déjà classés comme indésirables ou légitimes. Le modèle cherche les régularités qui distinguent les catégories, puis attribue un score aux nouveaux messages. La qualité des étiquettes est essentielle : si les exemples ont été classés trop vite, le système reproduira les erreurs de départ.
L’apprentissage non supervisé travaille sans étiquette cible. Il peut regrouper des clients selon leurs comportements d’achat ou identifier des structures récurrentes dans un ensemble de données. Les groupes obtenus ne sont pas automatiquement des segments utiles : une personne doit interpréter les résultats et vérifier qu’ils servent une décision concrète. Découvrir des motifs n’équivaut pas à démontrer une cause.
L’apprentissage semi-supervisé utilise un mélange d’exemples étiquetés et non étiquetés. Il peut être pertinent lorsqu’une entreprise possède beaucoup de documents, mais ne peut pas tous les annoter manuellement. L’apprentissage par renforcement suit une autre logique : un agent teste des actions et reçoit des récompenses ou des pénalités selon leurs conséquences. On l’emploie notamment dans certains problèmes de robotique ou de stratégie, où l’objectif consiste à apprendre une politique d’action.
Données structurées et non structurées : une distinction utile, pas absolue
Une donnée structurée suit une organisation définie, comme une ligne de table comportant une date, un montant et une catégorie. Une donnée non structurée peut être un courriel, une image, un enregistrement sonore ou un contrat dont la mise en page varie. Cette différence donne un premier indice pour choisir une approche, mais elle ne constitue pas une règle rigide : des méthodes de machine learning classiques peuvent traiter du texte après transformation, tandis que les systèmes de deep learning peuvent aussi exploiter des données structurées.
La question pratique est plutôt de savoir comment les données sont représentées et à quel niveau de complexité le modèle doit travailler. Une équipe marketing peut extraire des indicateurs simples d’avis clients — note, date, catégorie — puis les analyser avec un modèle classique. Si elle veut interpréter le texte lui-même, reconnaître le ton ou distinguer des sujets, des modèles de langage peuvent devenir plus adaptés, au prix de contrôles supplémentaires.
Dans les deux cas, la protection des données fait partie de la conception. Un projet qui manipule des informations personnelles doit limiter les accès, définir les durées de conservation et vérifier les conditions d’hébergement des outils utilisés. Ce sujet mérite d’être traité avant de transmettre des fichiers à un service externe ; un guide sur la protection des données en entreprise permet de poser les bonnes questions.
Mesurer les erreurs selon leur conséquence
Un taux de réussite global peut masquer des problèmes importants. Un système de détection de fraude qui signale trop de transactions légitimes fatigue les équipes et dégrade l’expérience client. À l’inverse, un outil qui laisse passer des cas risqués peut coûter cher. Il faut donc suivre plusieurs indicateurs : faux positifs, faux négatifs, temps de traitement, taux de vérification humaine et évolution de la qualité dans le temps.
Cette logique vaut aussi pour l’analyse documentaire. Un OCR peut lire correctement la plupart des mots tout en échouant sur les champs critiques, comme un numéro de facture ou un montant. Le tableau de bord doit exposer ces écarts plutôt que de masquer les difficultés derrière une moyenne flatteuse. Un apprentissage utile se juge à ses décisions dans le contexte réel, pas seulement à son score sur un jeu de test.
Choisir entre machine learning et deep learning pour un projet métier
Pour une entreprise, la bonne démarche commence par une définition opérationnelle du besoin. « Utiliser l’IA pour gagner du temps » est trop vague pour guider un choix. « Réduire le délai de tri des factures en orientant automatiquement les dossiers fiables et en envoyant les cas incertains à une vérification » est déjà exploitable. Cette formulation permet de mesurer le résultat, de fixer des limites et de comparer une automatisation à un processus existant.
Une méthode de décision en quatre étapes
- Décrire la décision à améliorer. S’agit-il de classer, prédire, extraire une information ou détecter une anomalie ? Définissez qui utilisera le résultat et ce qui se passe lorsqu’il est erroné.
- Auditer les données disponibles. Vérifiez leur volume, leur fraîcheur, leur diversité et leurs droits d’utilisation. Quelques milliers d’exemples propres peuvent être plus utiles qu’un grand stock de données incohérentes.
- Tester une solution simple comme référence. Une règle, un modèle statistique ou un algorithme classique fournit un point de comparaison. Sans référence, il est difficile de prouver qu’un modèle plus coûteux améliore réellement le processus.
- Mesurer le coût complet et organiser le contrôle. Intégrez l’entraînement, l’usage, la maintenance, l’accompagnement des équipes, la sécurité et le traitement des exceptions. Prévoyez une étape humaine pour les décisions sensibles ou les faibles niveaux de confiance.
Cette démarche évite un piège fréquent : construire une solution de bout en bout avant d’avoir validé le besoin. Pour un traitement de documents, il faut souvent combiner plusieurs briques : extraction OCR, classification, enrichissement, règles métier et détection de fraude. Les faire fonctionner de manière fiable, les maintenir et gérer les formats inattendus demande du temps. Acheter un outil spécialisé peut parfois être plus rationnel que développer chaque composant soi-même.
OCR et automatisation documentaire : choisir le bon niveau
Une entreprise qui traite des factures standardisées peut commencer par un logiciel OCR et un ensemble de règles de validation. Si les documents sont très variés, si des champs sont présentés de façons différentes ou si l’analyse doit interpréter du contenu, des modèles de deep learning peuvent améliorer l’extraction. Mais le dispositif doit conserver une voie de correction manuelle et signaler les informations incertaines plutôt que de les présenter comme certaines.
La détection de fraude ajoute une autre couche. Un modèle peut rechercher des incohérences entre un document, une transaction et l’historique d’un fournisseur. Il peut également faire remonter des motifs inhabituels pour examen. Pourtant, l’alerte reste un indice, pas une conclusion automatique : les règles métier, les contrôles d’identité et la validation d’un spécialiste gardent leur place. Le meilleur système est souvent hybride, avec des règles explicites pour les contrôles simples et des modèles pour les motifs difficiles à coder à la main.
Avant de bâtir un pipeline complet, comparez les performances de solutions existantes sur vos propres documents. Demandez comment les données sont hébergées, comment les erreurs sont corrigées et ce qui arrive lorsque le modèle ne reconnaît pas un champ. Les fonctionnalités affichées sur une page commerciale ne remplacent pas un test sur des cas réels. Pour intégrer ces briques à une stratégie plus large, il peut être utile de relier le projet à une démarche d’automatisation marketing par l’IA, à condition de ne pas confondre automatiser une tâche et améliorer tout un processus.
La réussite se mesure après le déploiement
Un prototype prometteur n’est pas encore un outil de production. Les données changent, les habitudes des équipes évoluent et de nouveaux formats apparaissent. Il faut donc suivre les résultats dans la durée, comparer les prédictions aux décisions finales et mettre à jour le modèle lorsque la performance baisse. Une intégration à un outil de suivi ou à des tableaux de bord de pilotage aide à rendre ces indicateurs visibles aux personnes responsables.
Il est également utile de définir les limites de l’automatisation dès le départ. Un système peut préparer une recommandation, préremplir un dossier ou classer une demande, tandis qu’un collaborateur valide les exceptions. Cette répartition rend le gain mesurable sans prétendre supprimer toute intervention humaine. Un projet d’IA solide automatise les tâches répétitives tout en gardant des contrôles là où une erreur aurait un coût élevé.
Le deep learning est-il toujours plus performant que le machine learning ?
Non. Le deep learning est particulièrement adapté à des problèmes complexes impliquant beaucoup de données, comme l’analyse d’images ou de sons. Pour des données tabulaires et une tâche bien définie, un modèle classique peut être plus rapide, moins coûteux et plus facile à contrôler.
Peut-on utiliser le machine learning sans GPU ?
Oui. De nombreux modèles classiques fonctionnent sur des processeurs standards. Un GPU devient surtout utile pour entraîner ou exécuter certains réseaux profonds, selon leur taille et le volume de données traité.
Quelle est la différence entre l’IA, le machine learning et le deep learning ?
L’intelligence artificielle est le domaine général. Le machine learning est une famille de méthodes permettant aux systèmes d’apprendre à partir de données. Le deep learning est une sous-famille du machine learning fondée sur des réseaux de neurones à plusieurs couches.
Le deep learning peut-il traiter des documents et des factures ?
Oui. Il peut contribuer à reconnaître la structure d’un document, extraire des informations et repérer des incohérences. La fiabilité dépend toutefois des formats, des données d’entraînement et des contrôles prévus pour les champs incertains.