Le deep learning est souvent présenté comme la réponse à tous les problèmes d’intelligence artificielle. En pratique, il excelle dans certains cas — reconnaître un défaut sur une image, transcrire un enregistrement ou comprendre une demande écrite — et se révèle inutilement lourd dans d’autres. Son intérêt ne se mesure donc pas à la sophistication du modèle, mais à l’écart entre le résultat obtenu et le coût nécessaire pour l’obtenir.
Pour décider si cet apprentissage profond mérite votre budget de calcul, il faut comprendre ce qui se passe dans un réseau de neurones, distinguer les types de données et comparer les solutions disponibles. Une boutique en ligne qui veut classer ses produits à partir de quelques colonnes n’a pas les mêmes besoins qu’un service qui analyse des milliers de photos. C’est cette différence, plus que l’effet de mode, qui guide le bon choix.
En bref :
- Le deep learning est une branche du machine learning fondée sur des réseaux de neurones composés de plusieurs couches.
- Il apprend lui-même les caractéristiques utiles à partir de données brutes, notamment des images, du son et du texte.
- Pour des données tabulaires, les modèles classiques sont souvent plus simples, moins chers et tout aussi efficaces.
- Les CNN sont associés à la vision, les RNN aux séquences et les transformers au langage et à de nombreux usages récents.
- Le coût réel inclut les données, les GPU, le déploiement, la maintenance et les exigences d’explicabilité.
Deep learning : définition et différence avec le machine learning
Le deep learning, ou apprentissage profond, est une branche du machine learning. Il s’appuie sur des réseaux de neurones artificiels organisés en plusieurs couches, capables d’apprendre à partir d’exemples. Au lieu de demander à une personne de décrire précisément les éléments importants d’une image, le système peut découvrir lui-même des motifs utiles pendant l’entraînement.
Cette capacité fait une vraie différence avec des données non structurées. Une photographie, un fichier audio ou un texte ne se présente pas comme un tableau de colonnes déjà prêtes à analyser. Un modèle classique a souvent besoin que l’on transforme ces données en caractéristiques mesurables. Avec l’apprentissage profond, une partie de ce travail de préparation est absorbée par le réseau.
Des caractéristiques apprises plutôt que définies à la main
Imaginez une entreprise qui veut repérer des produits abîmés sur des photos prises à l’entrepôt. Avec une méthode traditionnelle, il faudrait concevoir des critères visuels explicites : formes, contrastes, dimensions ou zones de couleur. Cette approche peut fonctionner, mais elle devient fragile si l’éclairage change ou si les défauts prennent des formes variées.
Un réseau profond peut apprendre une représentation progressive à partir d’exemples annotés. Sur une image, les premières couches peuvent répondre à des contours ou à des contrastes simples. Les couches suivantes combinent ces éléments pour reconnaître des formes, puis des objets ou des défauts plus complexes. Le modèle n’« observe » pas comme un humain : il ajuste des paramètres mathématiques afin de produire une prédiction utile.
Le choix dépend toutefois du problème, pas seulement du volume de données. Pour prévoir le montant d’une commande à partir de colonnes comme le pays, le canal d’acquisition et l’historique d’achat, une régression ou une forêt aléatoire peut fournir un excellent résultat. Ces modèles sont généralement plus faciles à entraîner, à contrôler et à expliquer.
Quand le deep learning prend l’avantage
La vision par ordinateur, la reconnaissance vocale et le traitement du langage sont des terrains favorables à ces réseaux, car les relations pertinentes sont difficiles à écrire sous forme de règles simples. Si une plateforme doit classer des milliers d’images de produits, repérer une anomalie sonore ou extraire le sens d’un message client, l’apprentissage de représentations complexes peut justifier l’investissement.
En revanche, une grande base de données tabulaire ne rend pas automatiquement le deep learning préférable. Un fichier contenant des millions de lignes et quelques dizaines de variables reste souvent mieux traité par des méthodes classiques. Le type de données, la qualité des étiquettes et le gain opérationnel attendu comptent davantage que la taille brute du fichier.
Pour approfondir la comparaison des approches, ce guide sur le machine learning face au deep learning aide à poser les bons critères avant de choisir une architecture. Le bon modèle n’est pas le plus avancé : c’est celui qui résout le problème au coût acceptable.
Comment fonctionne un réseau de neurones profond
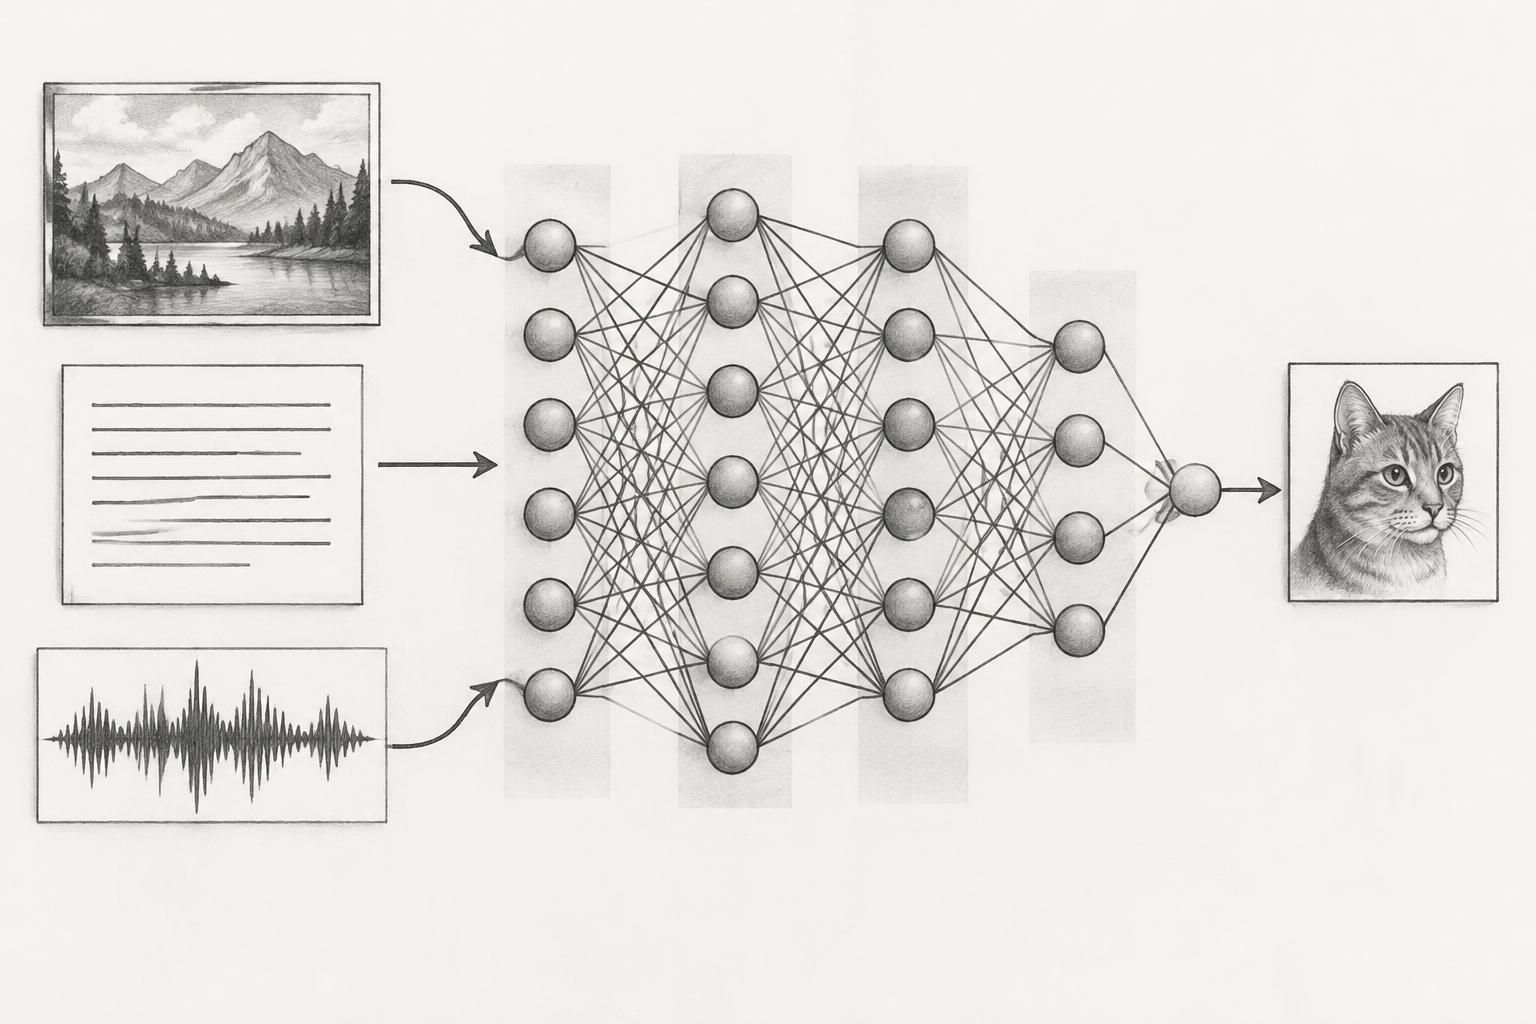
Un réseau de neurones artificiel s’inspire de loin du cerveau, mais il ne reproduit pas son fonctionnement biologique. Il s’agit d’un ensemble de calculs reliés entre eux. L’unité de base, souvent appelée neurone ou perceptron, reçoit des valeurs, leur attribue des poids, les combine, puis transforme le résultat avant de le transmettre à d’autres unités.
Les poids indiquent l’influence relative de chaque entrée. Si le réseau analyse une image, ses entrées peuvent correspondre aux valeurs des pixels. Le résultat d’un neurone dépend alors de la combinaison de ces valeurs et de ses paramètres appris. Une fonction d’activation introduit une transformation non linéaire : sans elle, empiler des couches reviendrait essentiellement à effectuer un calcul linéaire plus long, sans gagner la capacité de représenter des relations complexes.
Entrée, couches cachées et sortie
La couche d’entrée reçoit les données préparées pour le modèle. Les couches cachées les transforment successivement. La couche de sortie produit enfin une estimation, par exemple une classe, un score ou une valeur numérique. Dans un système de tri de photos, la sortie pourrait indiquer la probabilité qu’un produit soit intact, endommagé ou difficile à classer.
Le mot « profond » renvoie au nombre de couches intermédiaires, mais ajouter des couches ne garantit pas une meilleure solution. Une architecture trop complexe peut apprendre par cœur les exemples d’entraînement au lieu de reconnaître des régularités qui se retrouvent dans de nouvelles données. C’est le surapprentissage : le modèle semble performant pendant le développement, puis se dégrade lorsqu’il rencontre la réalité du terrain.
La boucle d’apprentissage et la rétropropagation
L’entraînement suit une boucle répétée. Les données traversent le réseau, qui produit une prédiction. Une fonction de perte mesure l’écart entre cette prédiction et la réponse attendue. La rétropropagation transmet ensuite cette erreur à travers les couches afin d’ajuster les poids, généralement à l’aide d’un algorithme d’optimisation.
Reprenons l’exemple des produits abîmés. Si le réseau classe une photo comme « intacte » alors qu’un opérateur l’a annotée « endommagée », la fonction de perte quantifie l’erreur. Le processus corrige progressivement les paramètres pour réduire ce type d’écart sur les exemples suivants. Répétée sur de nombreux lots de données, cette opération rend les prédictions plus utiles, sans garantir qu’elles seront toujours correctes.
Il faut donc séparer l’entraînement de l’évaluation. Une partie des exemples sert à ajuster le réseau ; d’autres, conservés à l’écart, servent à vérifier sa capacité à généraliser. Une validation faite uniquement sur les données déjà vues donne une impression trompeuse. Dans une entreprise, il est aussi prudent d’évaluer le modèle sur des cas récents et représentatifs des conditions réelles.
Un projet sérieux suit enfin des indicateurs adaptés au coût des erreurs. Pour une classification de défauts, manquer un produit dangereux n’a pas le même impact que déclencher un contrôle humain inutile. La qualité d’un réseau se juge à ses erreurs sur le terrain, pas au seul score affiché pendant l’entraînement.
Une fois cette boucle comprise, la question pratique devient plus concrète : quelle famille de réseau correspond à vos données, et le gain attendu justifie-t-il le calcul ?
Quand le deep learning vaut le coût de calcul
Le coût d’un modèle ne se limite pas à la facture d’un GPU. Il comprend le temps consacré à rassembler et nettoyer les données, à annoter des exemples, à tester des architectures, puis à déployer et surveiller la solution. Pour un entrepreneur ou une équipe produit, ces dépenses doivent être comparées à un résultat mesurable : moins de tâches manuelles, une meilleure détection, une réponse plus rapide ou une expérience client améliorée.
Dans le cas des données non structurées, le deep learning peut apporter une valeur difficile à obtenir autrement. Une entreprise qui reçoit des centaines de messages libres ne peut pas toujours prévoir à la main toutes les formulations possibles. Un modèle de langage peut catégoriser les demandes et orienter les cas simples, à condition de conserver un contrôle humain sur les situations ambiguës.
Le type de données comme premier filtre
Le tableau ci-dessous donne des repères de départ. Il ne remplace pas un test sur vos données : les performances varient selon la qualité des exemples, la définition de la cible et les contraintes de mise en production.
| Critère | Machine learning classique | Deep learning |
|---|---|---|
| Types de données fréquents | Tableaux, bases structurées | Images, texte, audio, vidéo |
| Caractéristiques | Souvent préparées ou sélectionnées | Apprises automatiquement dans les couches |
| Volume nécessaire | Peut fonctionner avec des jeux plus modestes | Demande souvent beaucoup d’exemples pertinents |
| Calcul | Un processeur classique suffit fréquemment | Des GPU peuvent accélérer fortement l’entraînement |
| Interprétation | Souvent plus accessible | Explication des décisions plus délicate |
| Exemples d’usages | Prévision de ventes, segmentation, scoring | Détection d’objets, transcription, compréhension de texte |
Calculer le coût complet, pas seulement l’entraînement
Un prototype peut tourner sur une machine puissante et rester économiquement viable. La difficulté apparaît parfois au moment de traiter chaque nouvelle requête. Si un service analyse des milliers d’images par jour, le coût d’inférence, c’est-à-dire celui des prédictions après entraînement, doit être mesuré sur un cycle d’activité réaliste.
Il faut aussi évaluer la latence et la fréquence de mise à jour. Une application qui doit répondre en quelques millisecondes n’a pas les mêmes contraintes qu’un traitement nocturne de fichiers. Dans certains cas, un modèle plus compact, un service externe ou une méthode classique offre un meilleur compromis. Une automatisation rentable n’est pas celle qui utilise le plus de technologie, mais celle qui réduit réellement le travail ou les erreurs.
Un processus simple protège contre les investissements prématurés :
- Définir le résultat attendu : formuler une tâche mesurable, comme réduire le temps de tri des demandes.
- Établir une référence : mesurer le processus manuel ou le modèle simple déjà disponible.
- Tester une solution de base : vérifier si une régression, un arbre ou une règle métier suffit.
- Comparer le deep learning : mesurer la qualité, le temps de réponse et le coût à volume réel.
- Décider selon le ROI : inclure maintenance, contrôle humain et gestion des données.
Ce raisonnement s’applique aussi à la transformation numérique au sens large : intégrer une technologie n’a de valeur que si elle améliore un processus concret. Un article sur l’innovation dans la transformation d’entreprise rappelle l’importance de relier l’outil aux opérations, plutôt que de lancer un projet pour suivre une tendance.
Le deep learning vaut son coût lorsque la complexité des données empêche une solution plus légère d’atteindre le niveau de qualité nécessaire. Si le gain ne dépasse pas les dépenses et les risques, la sophistication devient un handicap.
CNN, RNN et transformers : les principales architectures
Les réseaux profonds ne forment pas une seule architecture universelle. Plusieurs familles ont été conçues pour mieux traiter des structures particulières. Les trois repères les plus utiles sont les réseaux convolutifs, les réseaux récurrents et les transformers. Les connaître permet de comprendre pourquoi une technologie convient à une tâche et pas forcément à une autre.
CNN : repérer des motifs dans les images
Les réseaux convolutifs, ou CNN, sont historiquement associés à la vision par ordinateur. Ils examinent des zones locales d’une image et apprennent à détecter des motifs visuels. Des caractéristiques simples peuvent être combinées en formes plus complexes, puis en objets ou en défauts à reconnaître.
Une entreprise de fabrication peut, par exemple, utiliser un CNN pour signaler des rayures sur des pièces photographiées à la chaîne. Il faut toutefois des images représentatives : varier les angles, l’éclairage et les types de défauts évite de construire un système qui ne fonctionne que dans des conditions idéales. Si les photos de production sont différentes de celles de l’entraînement, la performance risque de chuter.
RNN et LSTM : traiter l’ordre des séquences
Les réseaux récurrents, ou RNN, ont été conçus pour traiter des données ordonnées, comme du texte, de l’audio ou des séries temporelles. Ils transmettent un état interne d’un élément de la séquence au suivant. Cette mémoire permet de tenir compte du contexte précédent, mais elle peut s’affaiblir lorsque la séquence devient longue.
Les variantes LSTM ont été pensées pour mieux conserver certaines informations au fil du temps. Elles ont été utilisées pour la reconnaissance vocale et la prévision de séries, entre autres. Pour une entreprise qui veut prévoir la demande à partir de l’historique des ventes, toutefois, un modèle classique spécialisé dans les séries ou une méthode plus simple peut demeurer plus facile à mettre en œuvre. Le choix doit venir d’un essai comparatif, pas du nom de l’architecture.
Transformers : l’attention appliquée aux séquences
Les transformers ont changé le traitement du langage en s’appuyant notamment sur un mécanisme d’attention. Au lieu de faire circuler uniquement une mémoire de proche en proche, le modèle peut mettre en relation différentes parties d’une séquence. Cette approche constitue le socle de nombreux grands modèles de langage et facilite le traitement de contextes complexes.
Dans un outil de support, un transformer peut aider à classer un message, extraire une demande ou proposer un brouillon de réponse. Il ne garantit pas que la réponse soit exacte : il faut contrôler les sorties, limiter l’accès aux données sensibles et définir les cas où une personne reprend la main. Un article consacré aux innovations autour de l’intelligence artificielle permet de replacer ces usages dans un paysage technologique plus large.
Ces architectures ne couvrent pas tout le domaine. Les autoencodeurs servent notamment à apprendre des représentations compactes ou à débruiter des données ; les réseaux de graphes analysent des relations entre entités ; les modèles de diffusion sont utilisés dans la génération d’images. D’autres approches ciblent les longues séquences ou des contraintes spécifiques.
La bonne question n’est donc pas « quelle architecture est la plus récente ? », mais « quelle structure de données faut-il modéliser, et quel résultat peut être vérifié ? ». Les familles de réseaux sont des outils spécialisés, pas des garanties de performance.
Les architectures donnent une direction, mais leur mise en pratique dépend aussi des frameworks et des compétences disponibles dans l’équipe.
Frameworks deep learning et méthode pour démarrer sans surinvestir
Construire chaque calcul à la main serait rarement un bon usage du temps. Les frameworks de deep learning gèrent les opérations sur les tenseurs, l’entraînement et la rétropropagation. Ils permettent de se concentrer sur la préparation des données, la définition du modèle et l’évaluation des résultats, plutôt que sur la réécriture de mécanismes déjà éprouvés.
PyTorch, TensorFlow et Keras
PyTorch est largement utilisé dans la recherche et s’est aussi développé en production. Sa souplesse facilite les expérimentations, ce qui en fait un choix fréquent pour prototyper et tester des architectures. Pour une équipe qui apprend en construisant, cette proximité avec le code peut rendre le comportement du modèle plus facile à inspecter.
TensorFlow propose un écosystème pensé pour entraîner et déployer des modèles à différentes échelles. Il peut convenir à des organisations qui ont déjà adopté ses outils ou qui recherchent des options de déploiement cohérentes avec leur infrastructure. Le meilleur choix dépend de l’équipe, du produit et des contraintes opérationnelles, pas d’un classement universel.
Keras offre une interface de plus haut niveau pour construire des réseaux avec moins de code. Intégré à l’écosystème TensorFlow, il aide à démarrer rapidement des modèles courants. Cette simplicité ne remplace pas les bases : une API facile à utiliser n’empêche pas de mal définir la cible, de mélanger les données d’entraînement et de test ou d’interpréter un indicateur de façon trompeuse.
Une progression pragmatique pour un projet web ou métier
Avant de choisir un framework, commencez par comprendre le problème métier et les données disponibles. Un site marchand qui veut prévoir le risque de rupture à partir de ventes historiques peut commencer avec des modèles classiques. Une équipe qui veut classer des images de produits doit plutôt examiner une solution de vision, puis comparer son efficacité à une vérification humaine assistée.
La progression la plus saine est graduelle. Python et les notions de machine learning donnent les bases nécessaires : découpage des données, métriques, surapprentissage et validation. Ensuite, un prototype réduit permet de tester la faisabilité avant d’investir dans des GPU, une infrastructure ou une annotation à grande échelle.
Voici les points à vérifier avant un déploiement :
- Les exemples couvrent-ils les conditions réelles, y compris les cas rares ?
- La qualité des annotations est-elle contrôlée et documentée ?
- Le modèle dépasse-t-il une solution simple sur un jeu de test indépendant ?
- Le coût de prédiction et le temps de réponse sont-ils acceptables ?
- Une personne peut-elle vérifier ou contester les décisions importantes ?
- Les données utilisées sont-elles protégées et traitées conformément aux règles applicables ?
Les données demandent une attention particulière lorsque des informations personnelles ou commerciales entrent dans le modèle. Il faut savoir où elles sont stockées, qui peut y accéder et combien de temps elles sont conservées. Les principes présentés dans ce guide sur la protection des données en entreprise sont utiles pour intégrer ces questions dès la conception, plutôt que de les traiter après le lancement.
Enfin, un modèle déployé n’est pas un projet terminé. Les données évoluent, les comportements changent et les performances peuvent se dégrader. Un suivi régulier, des seuils d’alerte et une procédure de retour à une méthode manuelle évitent de laisser une automatisation dériver sans contrôle. Commencer petit, mesurer le gain et renforcer l’architecture seulement si les résultats le justifient : c’est souvent la voie la plus rentable.
Le deep learning est-il une forme de machine learning ?
Oui. Le deep learning est une branche du machine learning qui utilise des réseaux de neurones à plusieurs couches pour apprendre des représentations à partir des données.
Faut-il toujours un GPU pour entraîner un réseau profond ?
Non. Un petit modèle peut être entraîné sur un processeur classique, mais un GPU accélère souvent les calculs sur des modèles volumineux ou des données comme les images et le texte.
Le deep learning convient-il aux données tabulaires ?
Il peut être utilisé, mais les modèles classiques sont souvent plus simples, moins coûteux et tout aussi performants sur des tableaux de données structurées. Il faut comparer les résultats sur un jeu de test indépendant.
Quel framework choisir pour débuter ?
PyTorch est apprécié pour sa souplesse, TensorFlow pour son écosystème de déploiement et Keras pour son approche accessible. Le choix dépend surtout de votre niveau, de votre équipe et de l’environnement technique du projet.