Le big data ne se résume pas à une montagne de fichiers. Le terme désigne des ensembles de données dont le volume, la vitesse de production ou la diversité compliquent leur stockage et leur analyse avec les outils classiques. Le seuil ne se mesure donc pas seulement en gigaoctets ou en téraoctets : il apparaît lorsque l’infrastructure, les méthodes et les équipes doivent changer pour extraire une information utile.
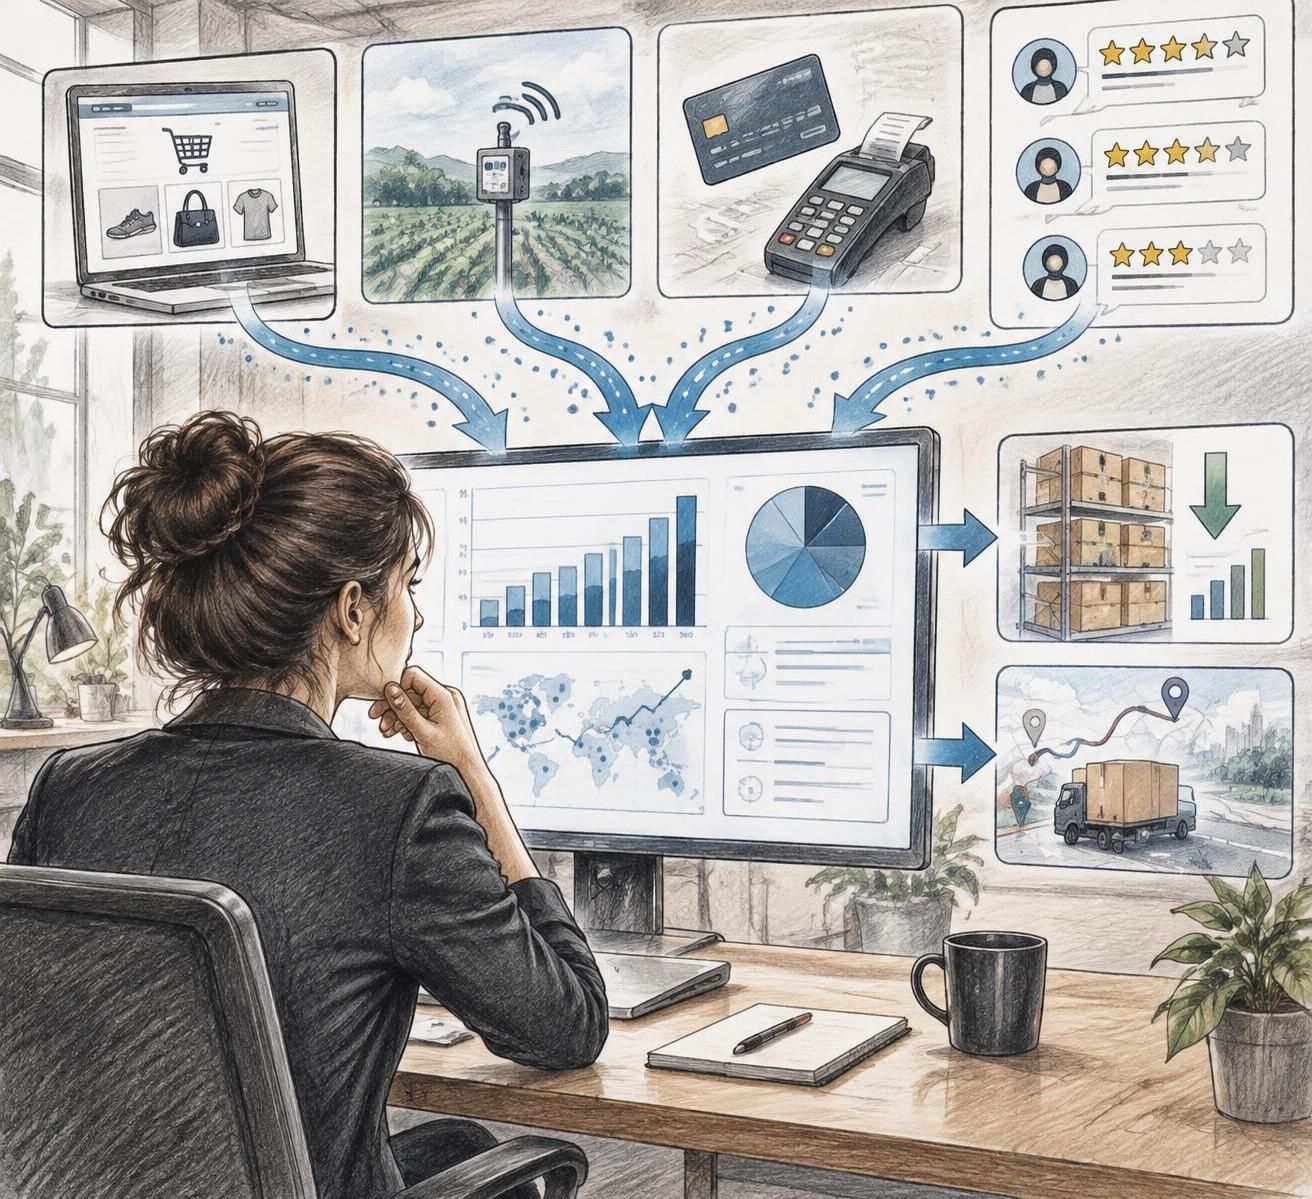
Une boutique en ligne qui suit ses ventes dans un tableur n’a pas nécessairement besoin d’une architecture big data. Mais si elle doit rapprocher en temps réel des clics, des achats, des stocks, des avis et des données issues de capteurs, le problème devient différent. La question pertinente n’est pas « combien de données ? », mais « les outils actuels savent-ils encore les traiter correctement, au bon coût et dans les délais nécessaires ? »
En bref
- Le big data se définit par la difficulté à gérer des données à grande échelle, pas par un seuil universel de stockage.
- Les 3 V — volume, vélocité et variété — restent des repères pratiques, complétés par la véracité et la valeur.
- Les données structurées, semi-structurées et non structurées demandent des méthodes de traitement différentes.
- Une architecture distribuée ou cloud n’est utile que si elle répond à un besoin métier réel.
- La qualité, la gouvernance et la protection des données déterminent souvent la valeur obtenue.
Big data : définition et critères pour savoir où commence le « big »
Une donnée est une représentation d’un fait : un montant de commande, une date, une mesure de température, un mot dans un commentaire ou une image envoyée par un téléphone. Seule, elle renseigne peu. Reliée à d’autres et replacée dans son contexte, elle peut aider à comprendre un comportement, repérer une anomalie ou décider d’une action.
Le big data, ou mégadonnées, désigne des ensembles suffisamment volumineux, rapides ou hétérogènes pour mettre en difficulté les outils et les pratiques traditionnels de stockage et d’analyse. Cela ne signifie pas qu’une entreprise doit posséder une quantité spectaculaire de fichiers pour être concernée. Un flux modeste, mais reçu en continu et devant être traité en quelques secondes, peut présenter un défi plus important qu’une archive volumineuse consultée rarement.
Les 3 V, une grille utile mais pas un seuil magique
Le modèle des 3 V offre une première manière de comprendre le phénomène. Le volume correspond à la quantité de données à conserver et à traiter. La vélocité décrit la vitesse à laquelle elles sont créées, transmises et exploitées. La variété renvoie aux formats et aux sources : transactions, journaux d’activité, textes, images, vidéos ou mesures de capteurs.
Ces trois caractéristiques ont été formulées par Doug Laney au début des années 2000, à une période où le web, les systèmes transactionnels et les données d’entreprise changeaient rapidement d’échelle. Le modèle reste pertinent, mais il est souvent complété par la véracité, qui concerne la fiabilité des informations, et la valeur, c’est-à-dire l’intérêt concret qu’une organisation peut en tirer. Ajouter des données sans objectif ne crée pas automatiquement de valeur.
Imaginons une marque de vêtements qui vend quelques centaines de produits par mois. Un tableur et un outil de commerce électronique peuvent suffire pour suivre les commandes. Si elle lance plusieurs boutiques, reçoit des millions d’événements de navigation et veut adapter ses recommandations en temps réel, les limites apparaissent : ralentissements, traitements manuels, rapprochements compliqués ou analyses tardives. Le « big » commence alors au point de rupture entre le besoin et la capacité des outils en place.
Un problème de capacité, de délai et de coût
Il n’existe donc pas de nombre universel de lignes ou de téraoctets qui transforme une base de données en big data. Une organisation peut rencontrer ces enjeux avec des volumes modestes si les données arrivent en continu, doivent être combinées rapidement ou exigent une forte disponibilité. À l’inverse, une archive massive mais stable et rarement consultée peut être gérée avec des solutions simples, si le délai de réponse n’est pas critique.
Le bon diagnostic consiste à observer ce qui bloque : les requêtes prennent-elles trop de temps ? Les équipes ne parviennent-elles plus à réunir les sources ? Le stockage augmente-t-il plus vite que le budget ? Les données arrivent-elles trop tard pour guider une décision ? Quand ces contraintes exigent une architecture distribuée, des traitements parallèles ou des règles de gouvernance renforcées, le sujet dépasse la simple croissance d’une base de données.
Le big data commence lorsque l’échelle transforme les choix techniques et organisationnels, pas lorsqu’un compteur franchit un chiffre rond.
Les 5 V du big data et les différents types de données
Les 3 V expliquent l’essentiel, mais ils ne suffisent pas toujours à évaluer un projet. Une entreprise peut collecter énormément de données sans pouvoir leur faire confiance, ou investir dans des traitements sophistiqués sans trouver d’usage rentable. Les notions de véracité et de valeur obligent à regarder au-delà de la puissance de calcul.
Volume, vélocité et variété dans la pratique
Le volume est le critère le plus visible. Il augmente avec les transactions, les historiques de navigation, les sauvegardes, les contenus multimédias ou les appareils connectés. Mais le volume seul ne dit rien de la difficulté : une grande table bien organisée peut se traiter efficacement, alors qu’un ensemble plus petit composé de fichiers dispersés peut demander beaucoup de préparation.
La vélocité devient centrale quand la décision doit suivre le rythme de l’événement. Un système de paiement peut chercher à repérer une opération suspecte au moment où elle se produit. Un opérateur de transport peut surveiller des capteurs afin de détecter un équipement qui s’écarte de son fonctionnement habituel. Dans ces situations, une analyse hebdomadaire ne suffit pas : le délai de traitement fait partie du besoin métier.
La variété, elle, oblige à rapprocher des informations qui ne se présentent pas de la même façon. Une entreprise peut disposer de commandes dans une base relationnelle, de commentaires en texte libre, de photos de produits et de données issues d’une application mobile. Pour les exploiter ensemble, il faut définir des formats, des identifiants communs et des règles de transformation. C’est souvent là que se cache une part importante du travail.
Données structurées, semi-structurées et non structurées
Les données structurées suivent un schéma défini : une table de commandes peut contenir un numéro, une date, un montant et un identifiant client. Elles sont généralement adaptées aux bases relationnelles et aux requêtes organisées. Leur structure ne les rend pas automatiquement faciles à gérer si le volume, la fréquence des mises à jour ou le nombre d’utilisateurs deviennent élevés.
Les données semi-structurées conservent des repères, mais sans adopter toujours le modèle rigide d’une table. Des formats comme JSON ou XML peuvent contenir des champs variables selon l’événement. Les données non structurées incluent notamment des images, des vidéos, des documents ou des commentaires libres. Elles peuvent être riches en signaux, mais demandent souvent des étapes de préparation, d’indexation ou de traitement par des modèles spécialisés.
Une petite entreprise qui analyse les avis clients peut commencer par classer manuellement quelques centaines de commentaires. À mesure que les sources se multiplient, elle peut appliquer du traitement automatique du langage pour regrouper les thèmes et repérer l’évolution du sentiment. Le modèle ne remplace pas la vérification : un commentaire ironique ou ambigu peut être mal interprété. Les données doivent rester reliées à leur origine et à leur contexte.
Véracité et valeur : les deux filtres à ne pas oublier
La véracité désigne la fiabilité et la cohérence des informations. Des doublons, des champs vides, des horodatages erronés ou des identifiants incohérents peuvent fausser un indicateur aussi bien qu’un mauvais calcul. Avant d’entraîner un modèle d’IA ou de comparer des campagnes, il faut donc contrôler les données et documenter leur provenance. Des pratiques de qualité des données aident à limiter les décisions fondées sur des signaux trompeurs.
La valeur se mesure par l’usage : meilleure prévision, réduction d’une panne, amélioration du service ou hausse d’une conversion. Une équipe marketing peut découvrir que les visiteurs qui consultent une page d’aide avant l’achat abandonnent moins souvent leur panier. Cette information n’a d’intérêt que si elle mène à une action testable, puis à une mesure de son effet.
Les données utiles ne sont pas nécessairement les plus nombreuses : elles sont compréhensibles, fiables et reliées à une décision.
Sources du big data et usages concrets dans les entreprises
Les sources de mégadonnées varient selon le secteur et le modèle économique. Les systèmes de transactions enregistrent achats, paiements et retours. Les outils de relation client conservent les échanges et les demandes d’assistance. Les sites et applications produisent des journaux de navigation, tandis que les réseaux sociaux et les avis en ligne révèlent des opinions publiques, avec les précautions nécessaires sur leur représentativité.
L’Internet des objets élargit encore le paysage. Des capteurs installés dans une usine mesurent la vibration, la température ou la consommation d’une machine. Un véhicule peut transmettre des informations de localisation et d’état. Dans le domaine médical, des appareils et des dossiers de santé peuvent contribuer à la recherche ou au suivi des patients, sous des règles strictes de confidentialité et de sécurité.
Du signal à l’action métier
Une entreprise de commerce en ligne peut rapprocher les recherches internes, les clics et les achats pour comprendre les besoins non satisfaits. Si un produit est souvent recherché mais peu acheté, la cause peut être un prix mal positionné, une fiche incomplète ou une rupture de stock. L’analyse devient utile quand elle aide à distinguer ces hypothèses et à lancer un test mesurable, plutôt que d’accumuler des tableaux de bord.
Dans l’industrie, l’analyse prédictive peut aider à anticiper une défaillance à partir des mesures d’équipements. Cela ne signifie pas que le modèle « sait » qu’une machine va tomber en panne. Il repère des motifs associés à des incidents passés et fournit un signal à vérifier par des équipes compétentes. Si une alerte déclenche une inspection ciblée et évite un arrêt coûteux, la chaîne de valeur est tangible.
Les services financiers utilisent des flux de transactions pour évaluer des risques ou détecter des activités atypiques. Les autorités et les chercheurs peuvent exploiter des données agrégées pour étudier des tendances de mobilité ou de santé. Chaque cas exige de contrôler les biais : une population mal représentée ou un historique incomplet peut produire une analyse convaincante en apparence, mais injuste ou trompeuse.
Marketing, sentiment et analyse comparative
Les techniques d’analyse comparative permettent de suivre ses performances dans le temps ou de les situer par rapport à des références pertinentes. L’analyse marketing relie les campagnes aux comportements : canal d’acquisition, consultation, inscription et conversion. Pour être fiable, le parcours doit être mesuré avec des définitions stables. Sinon, deux équipes peuvent attribuer la même vente à des canaux différents et croire chacune avoir raison.
L’analyse de sentiment examine les avis, commentaires et messages afin de repérer les thèmes qui reviennent. Une hausse des mentions négatives sur les délais de livraison peut inciter à vérifier la logistique avant d’augmenter le budget publicitaire. Ce type d’analyse ne remplace ni l’écoute client ni l’examen d’exemples précis. Il sert à repérer plus vite les zones qui méritent une attention humaine.
Pour suivre les résultats, une entreprise peut bâtir une visualisation de données qui met en regard quelques indicateurs utiles : disponibilité du stock, délai de livraison et taux de retour. Une visualisation claire réduit le temps passé à interpréter les chiffres. Elle ne corrige toutefois ni une mauvaise définition des indicateurs ni une source défectueuse.
Le fil conducteur reste simple : collecter seulement ce qui sert à mieux comprendre un problème, puis tester une action. Une stratégie data-driven ne consiste pas à obéir aveuglément aux tableaux de bord ; elle organise la confrontation entre données, expérience métier et résultats observés.
Un usage réussi du big data transforme un signal dispersé en décision vérifiable, pas en simple accumulation de rapports.
Infrastructure big data : cloud, calcul distribué et outils d’analyse
Quand un seul serveur ne peut plus stocker ou traiter les données dans les délais attendus, les organisations peuvent répartir le travail sur plusieurs machines. Cette approche distribuée permet de diviser un calcul en tâches plus petites, traitées en parallèle. Elle peut accélérer certaines opérations et accroître la capacité, mais elle ajoute aussi des composants à configurer, surveiller et sécuriser.
Hadoop, Spark et les architectures de données
Hadoop a contribué à populariser le stockage distribué et le traitement par lots à grande échelle. Spark permet différents traitements distribués, notamment l’analyse en mémoire lorsque la charge et l’architecture s’y prêtent. Kafka est utilisé pour transporter et traiter des événements en flux, tandis que des bases NoSQL répondent à certains besoins de données flexibles ou de forte disponibilité. Ces noms ne forment pas une recette à assembler systématiquement.
Le choix dépend de la question posée. Une analyse nocturne d’historiques peut relever d’un traitement par lots. Une alerte qui doit arriver en quelques secondes nécessite une chaîne de streaming. Un entrepôt de données facilite les requêtes analytiques sur des informations préparées et structurées. Un data warehouse bien conçu peut ainsi apporter davantage qu’une infrastructure très complexe montée trop tôt.
Les architectures modernes séparent souvent le stockage du calcul. Cela permet de conserver des données dans un espace évolutif, puis de mobiliser des ressources de traitement selon les besoins. Les services cloud proposent des capacités à la demande, mais « extensible » ne signifie pas « gratuit » ni « sans limite pratique ». Des requêtes mal optimisées, des copies inutiles et des flux laissés actifs peuvent faire grimper la facture.
Cloud ou infrastructure sur site ?
Le cloud public est attractif pour tester un projet sans acheter immédiatement des serveurs. L’entreprise ajuste les ressources, utilise des services managés et évite une partie de la maintenance matérielle. En contrepartie, elle doit surveiller les coûts, maîtriser les accès, comprendre les conditions de conservation et vérifier la localisation des données lorsque la réglementation l’exige.
Une infrastructure sur site peut rester pertinente pour des contraintes de souveraineté, de latence, de sécurité ou d’intégration avec des équipements existants. Certaines organisations choisissent une approche hybride : les traitements sensibles restent dans un environnement contrôlé, tandis que des analyses moins critiques exploitent le cloud. La décision se prend à partir des risques, des compétences disponibles et du coût total, pas d’une tendance technologique.
Avant de migrer, une équipe peut réaliser un test limité sur un cas d’usage précis. Elle mesure le temps de traitement, le coût par analyse, le taux d’erreur et l’effort de maintenance. Si le projet ne produit pas un gain observable, augmenter les ressources ne résoudra pas le problème de départ. L’architecture doit servir la stratégie de données, plutôt que devenir un chantier autonome.
Préparer les données avant de calculer
Les chaînes de traitement extraient les données de leurs sources, les nettoient, les transforment et les rendent disponibles aux outils d’analyse. Ce travail est parfois moins spectaculaire que l’entraînement d’un modèle, mais il conditionne la qualité du résultat. Une date enregistrée dans plusieurs fuseaux horaires ou un même client associé à trois identifiants peut fausser une prévision ou un rapport financier.
La gouvernance précise qui peut consulter, corriger et partager chaque jeu de données. Elle documente les définitions, les règles de conservation et les responsables. Une organisation peut aussi suivre la provenance : d’où vient l’information, quelles transformations lui ont été appliquées et quels rapports l’utilisent ? Cette traçabilité aide à diagnostiquer une anomalie et à répondre aux obligations réglementaires.
Les données personnelles exigent une attention particulière. Le principe de minimisation consiste à ne collecter que ce qui est nécessaire à une finalité définie. Les accès doivent être limités, les durées de conservation justifiées et les usages compatibles avec les droits des personnes. En pratique, une architecture performante sans sécurité ni gouvernance reste une dette technique et juridique.
Le meilleur outil est celui qui répond au besoin mesuré avec une complexité et un coût que l’équipe peut réellement maîtriser.
Big data et IA : méthode pour créer une valeur mesurable
Le rapprochement entre big data et intelligence artificielle attire l’attention, car les modèles apprennent à partir d’exemples. Mais un grand volume n’assure ni un modèle exact ni une décision utile. Des données mal étiquetées, obsolètes ou biaisées peuvent amplifier les erreurs. Avant de choisir un algorithme, il faut formuler le problème métier dans des termes que l’on pourra évaluer.
Partir d’une décision, pas d’un outil
Une équipe de support peut vouloir réduire le délai de réponse. Elle peut commencer par examiner le volume de demandes, les catégories, les temps de résolution et les périodes de pointe. Si le problème vient surtout de questions récurrentes, une base de connaissances mieux organisée peut suffire. Si les demandes affluent sur plusieurs canaux et dépassent les capacités de tri, une classification automatisée mérite un test.
La démarche consiste à définir une mesure de départ, sélectionner les données nécessaires, construire une première solution, puis comparer les résultats. Pour un modèle de prévision du désabonnement, l’entreprise doit préciser ce qui compte comme un départ, à quelle échéance la prédiction sera faite et quelle action l’équipe peut déclencher. Sans réponse à ces questions, un score de risque reste un nombre sans effet opérationnel.
Un test contrôlé permet de vérifier l’impact. Un groupe de clients peut recevoir une action de fidélisation ciblée, tandis qu’un groupe comparable suit le parcours habituel. Il faut examiner non seulement les ventes, mais aussi les coûts, les désabonnements, les plaintes et les éventuels effets indésirables. Une automatisation qui augmente les conversions tout en dégradant la confiance peut détruire de la valeur à long terme.
Éviter les pièges du projet data
Le premier piège est la collecte sans finalité. Conserver chaque événement « au cas où » augmente les coûts et les risques, sans garantir qu’il sera exploitable. Le deuxième consiste à acheter une plateforme avant d’avoir clarifié les processus. Un outil ne réconcilie pas par magie des définitions contradictoires entre les équipes ventes, produit et marketing.
Le troisième piège est de confondre corrélation et causalité. Si les clients qui ouvrent une newsletter achètent davantage, cela ne prouve pas que l’ouverture a causé l’achat : les clients les plus engagés peuvent à la fois ouvrir les courriels et acheter plus souvent. Des expériences, des comparaisons adaptées et une lecture critique des résultats réduisent ce risque.
Pour un entrepreneur web, le principe est le même à petite échelle. Les données SEO, les conversions et les événements d’un site peuvent révéler les pages qui attirent un trafic utile et celles qui n’aboutissent pas. Il vaut mieux mesurer quelques parcours fiables que multiplier des indicateurs de vanité. Un tableau de bord doit aider à choisir quoi tester ensuite, pas seulement rendre le site plus impressionnant en réunion.
Une feuille de route pragmatique
Une première étape consiste à cartographier les sources et à vérifier les droits d’usage. La suivante est de choisir un cas d’usage limité, avec un responsable métier et un indicateur compréhensible. L’équipe vérifie ensuite la qualité, prépare les données et compare les options techniques en incluant les coûts d’exploitation, de sécurité et de maintenance.
- Clarifier le besoin : quelle décision ou quel processus doit être amélioré ?
- Établir une référence : comment le résultat est-il mesuré aujourd’hui ?
- Contrôler les données : sont-elles complètes, cohérentes et autorisées pour cet usage ?
- Tester à petite échelle : l’outil apporte-t-il un bénéfice démontrable face à une méthode simple ?
- Documenter et surveiller : les résultats restent-ils fiables lorsque les comportements et les sources évoluent ?
Cette méthode évite de confondre modernisation et accumulation technologique. Elle facilite aussi le dialogue entre les profils métier, les spécialistes de la donnée et les équipes techniques. Une stratégie data utile relie les investissements à des objectifs explicites, tandis qu’un processus de data management garde les informations gouvernables au fil du temps.
La valeur du big data se démontre par une amélioration mesurée ; elle ne se déduit ni du volume collecté ni du nom de l’outil choisi.
Pour approfondir la manière dont les données deviennent une ressource exploitable, une seconde vidéo peut compléter les exemples d’architecture et d’analyse. Gardez le même réflexe : relier chaque technologie à un besoin concret avant de l’adopter.
À partir de quelle quantité parle-t-on de big data ?
Il n’existe pas de seuil universel en gigaoctets ou en téraoctets. Le terme devient pertinent lorsque le volume, la vitesse ou la variété des données dépasse les capacités pratiques des outils et méthodes déjà en place.
Quelle est la différence entre données structurées et non structurées ?
Les données structurées suivent un schéma défini, comme les colonnes d’une table de commandes. Les données non structurées, telles que des images, vidéos ou commentaires libres, n’ont pas cette organisation fixe et demandent souvent une préparation spécifique.
Le big data est-il réservé aux grandes entreprises ?
Non. Une petite entreprise peut rencontrer des enjeux de big data si elle doit traiter rapidement des sources nombreuses ou hétérogènes. Elle peut toutefois commencer avec des outils simples et ne passer à une architecture spécialisée que lorsque des limites concrètes apparaissent.
Quel est le lien entre big data et intelligence artificielle ?
Les projets d’IA s’appuient souvent sur des données pour entraîner ou évaluer des modèles. Un grand volume n’assure pas de bons résultats : la pertinence, la qualité, la représentativité et la gouvernance des données restent déterminantes.