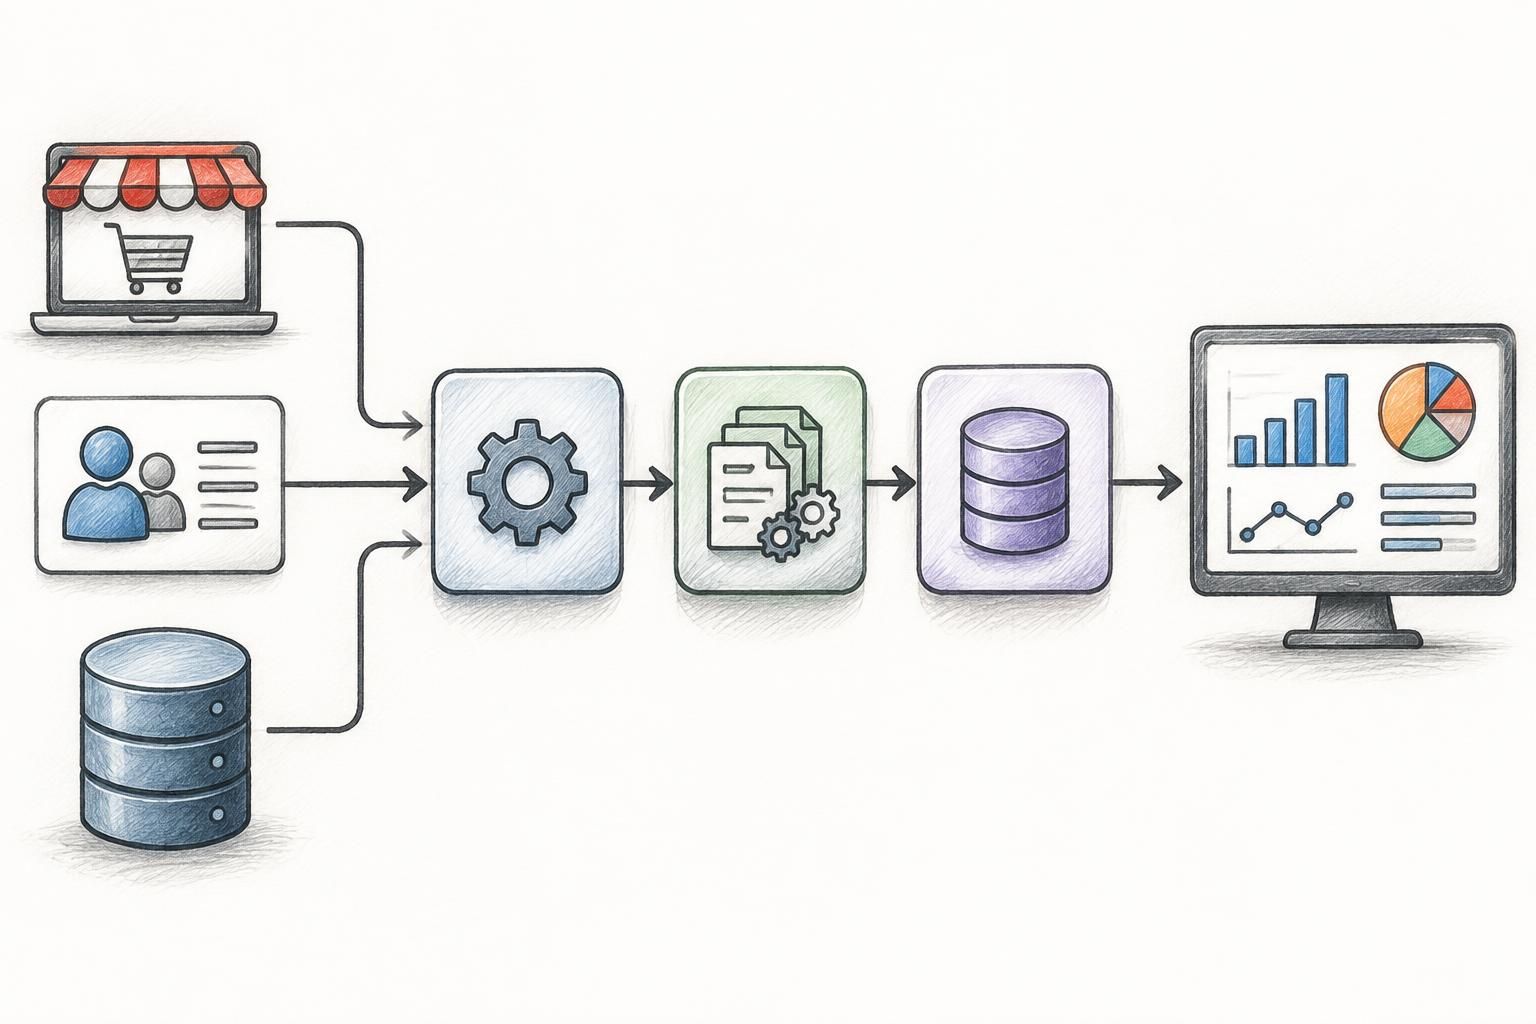
Une entreprise peut disposer d’un CRM, d’un outil de facturation, d’une boutique en ligne et d’une plateforme marketing sans parvenir à relier correctement les informations qu’ils produisent. Les chiffres existent, mais ils restent dispersés, parfois contradictoires et souvent trop anciens pour guider une décision. C’est là qu’intervient l’ETL : un processus qui extrait les données de différentes sources, les transforme pour les rendre cohérentes, puis les charge dans un système où elles peuvent être exploitées.
Ce mécanisme ressemble à un tuyau invisible. Bien conçu, il alimente les tableaux de bord sans demander à une équipe de copier des fichiers chaque matin. Mal surveillé, il peut propager des erreurs à grande vitesse. Comprendre les choix d’architecture, les étapes du pipeline et les contrôles de qualité permet donc de faire de l’ETL un véritable outil de pilotage, et non une simple opération technique.
En bref : comprendre le rôle d’un pipeline ETL
- ETL signifie extraire, transformer et charger : les données passent des systèmes sources à une destination où elles deviennent utilisables.
- ETL et ELT répondent à des architectures différentes : le premier transforme avant le chargement, le second charge d’abord les données brutes puis les transforme.
- Le batch convient aux mises à jour périodiques, tandis que le streaming s’adresse aux usages où quelques secondes de délai peuvent compter.
- La qualité, le suivi des erreurs et l’idempotence sont indispensables pour éviter des tableaux de bord incomplets ou des enregistrements dupliqués.
- Le bon outil dépend des sources, des volumes, des compétences et des coûts, pas de la popularité d’une plateforme.
ETL en informatique : les trois étapes qui rendent les données exploitables
Un pipeline ETL organise le déplacement des informations entre des systèmes qui ne parlent pas forcément le même langage. Une boutique en ligne peut enregistrer les commandes dans une base de données, le CRM stocker les échanges commerciaux et l’outil comptable suivre les paiements. Pris séparément, ces logiciels donnent chacun une partie de l’histoire. Reliés de façon fiable, ils peuvent aider à comprendre le chiffre d’affaires, la récurrence des achats ou le coût d’acquisition d’un client.
Extraire sans perdre le fil des sources
La première étape consiste à récupérer les données depuis des bases SQL, des API, des fichiers ou des applications métier. L’extraction peut être complète, lorsqu’on rapatrie tout le contenu disponible, ou incrémentale, lorsqu’on ne récupère que les nouveaux enregistrements et les changements récents. Cette seconde méthode évite de retraiter inutilement des volumes déjà connus, à condition que la source fournisse un moyen fiable de repérer les modifications.
Prenons Atelier Nord, une entreprise fictive qui vend des accessoires de bureau. Son site produit une commande à chaque vente, son CRM conserve les informations de suivi et sa solution de paiement enregistre les transactions. Le pipeline doit identifier les nouveaux éléments sans confondre une commande modifiée avec une nouvelle commande. Il doit aussi gérer les coupures réseau et les limites de requêtes imposées par certaines API.
Transformer pour donner un sens commun
Les données brutes sont rarement prêtes à être comparées. Une plateforme peut enregistrer une date au format jour-mois-année, une autre au format année-mois-jour. Les noms de pays peuvent varier, les devises différer et les mêmes clients apparaître plusieurs fois sous des adresses légèrement différentes. La transformation consiste à nettoyer, normaliser, enrichir ou rapprocher ces éléments selon des règles explicites.
Pour Atelier Nord, une règle métier pourrait convertir toutes les ventes dans la devise de référence, harmoniser les dates et distinguer les commandes payées des paniers abandonnés. Il faut documenter ces choix : sinon, un indicateur de ventes peut inclure des remboursements ou exclure des commandes pourtant validées. La transformation n’est donc pas un simple polissage technique. Elle traduit les définitions opérationnelles de l’entreprise en traitements reproductibles.
Charger au bon endroit
La dernière étape écrit les informations préparées dans une destination : entrepôt de données, base analytique ou autre système de stockage. Le chargement peut remplacer un jeu de données, ajouter de nouveaux enregistrements ou mettre à jour les lignes déjà présentes. Une zone de préparation intermédiaire est souvent utile pour vérifier le résultat avant de publier les données aux équipes.
Un flux bien conçu donne aussi de la visibilité sur ce qui s’est passé : volume reçu, lignes rejetées, durée de traitement et heure de dernière mise à jour. Ces informations facilitent le diagnostic lorsqu’un tableau de bord semble soudain incomplet. Un ETL utile ne se contente pas de déplacer des données : il rend leur origine et leur traitement compréhensibles.
ETL ou ELT : choisir une architecture adaptée à ses données
ETL et ELT désignent deux façons d’organiser l’intégration des données. Dans un modèle ETL traditionnel, les informations sont transformées avant d’être chargées dans leur destination finale. Dans un modèle ELT, elles sont d’abord déposées dans l’entrepôt, puis transformées grâce aux capacités de calcul de cette plateforme. Les deux approches peuvent produire des données fiables ; le choix dépend surtout de l’infrastructure, des contraintes de sécurité et des besoins d’analyse.
Quand l’ETL garde l’avantage
Transformer avant le chargement peut être pertinent lorsque les données doivent être filtrées ou masquées avant d’atteindre la destination. Une entreprise peut, par exemple, retirer des informations personnelles inutiles à l’analyse ou convertir des fichiers anciens dans un format attendu par un système métier. Cette logique limite aussi l’envoi de données brutes vers une plateforme où elles n’ont pas vocation à être conservées.
En contrepartie, il faut maintenir l’environnement intermédiaire chargé des transformations. Si les règles métier changent, les traitements en amont doivent être adaptés et testés. Pour Atelier Nord, cela peut convenir si les données de paiement doivent être fortement filtrées avant leur stockage analytique. La règle pratique est simple : transformer tôt lorsque la sécurité, le format de destination ou la maîtrise du volume l’exigent réellement.
Pourquoi le cloud a accéléré l’ELT
Les entrepôts de données modernes proposent des ressources de calcul capables de traiter de grands volumes après leur chargement. L’ELT permet alors de conserver une copie relativement brute des données, puis de créer plusieurs vues adaptées aux usages financiers, marketing ou opérationnels. Si une définition d’indicateur évolue, l’équipe peut parfois reconstruire les transformations à partir de cette base sans refaire toute l’extraction.
Cette souplesse a un coût. Des données brutes mal gouvernées peuvent encombrer le stockage, exposer des informations inutiles ou faire augmenter la consommation de calcul. Les transformations doivent aussi être documentées et testées dans la destination. Pour éviter les surprises, il faut suivre les volumes, les temps d’exécution et la facture associée aux requêtes. Le cloud simplifie l’accès à la puissance ; il ne rend pas les ressources gratuites.
Comparer les deux modèles sur un cas concret
Imaginons qu’Atelier Nord veuille rapprocher les ventes du site, les campagnes publicitaires et les retours clients. Avec l’ETL, les formats peuvent être harmonisés avant l’arrivée dans l’entrepôt. Avec l’ELT, les sources sont chargées dans un espace central, puis les transformations sont exécutées à cet endroit pour produire des tables d’analyse. Une architecture hybride peut aussi être pertinente : filtrage des données sensibles en amont, puis modélisation analytique dans l’entrepôt.
La décision doit tenir compte des compétences disponibles. Une équipe à l’aise avec la modélisation SQL peut préférer transformer dans l’entrepôt ; une équipe contrainte par des systèmes anciens peut s’appuyer sur des traitements intermédiaires. Pour relier les données à des indicateurs compréhensibles, le pipeline peut alimenter un dispositif de business intelligence et de reporting. Le meilleur modèle est celui que l’équipe sait sécuriser, expliquer et faire évoluer.
Les composants d’un pipeline ETL fiable : qualité, règles et reprise
Un pipeline ne se limite pas à trois opérations enchaînées. Il comprend des connecteurs vers les sources, des règles de transformation, un système de stockage, des contrôles et des mécanismes de suivi. Oublier l’un de ces éléments revient à installer un tuyau sans vérifier ses raccords : les données peuvent circuler, mais personne ne sait si elles arrivent complètes et dans le bon état.
Connecteurs et stratégies d’extraction
Les sources ne proposent pas toutes les mêmes possibilités. Certaines API signalent les enregistrements modifiés depuis une date donnée ; d’autres imposent de parcourir des pages de résultats. Une base relationnelle peut fournir un journal de changements, alors qu’un fichier déposé chaque semaine nécessite une comparaison avec la version précédente. Le mode d’extraction doit donc être défini source par source.
Une extraction complète est facile à comprendre, mais devient coûteuse si les tables grossissent. Une extraction incrémentale est plus légère, mais dépend d’une clé fiable, comme une date de modification ou un identifiant croissant. Il est prudent de prévoir une réconciliation périodique : comparer un échantillon ou un total avec la source permet de repérer les changements manqués. Un connecteur n’est pas fiable uniquement parce qu’il fonctionne lors du premier essai.
Règles de transformation et tests de données
Les transformations devraient exprimer des règles métier vérifiables. Par exemple, une commande ne peut pas avoir une date de paiement antérieure à sa création ; un montant remboursé ne doit pas dépasser le montant initial ; un identifiant client ne devrait pas être vide dans une table de commandes finalisées. Ces contrôles peuvent signaler une anomalie, bloquer un chargement ou placer les lignes concernées en quarantaine pour examen.
La validation des schémas protège aussi contre les changements inattendus. Si une application renomme un champ ou change son type, le pipeline peut échouer proprement au lieu de produire des résultats faux sans avertissement. Atelier Nord pourrait, par exemple, recevoir un champ de prix sous forme de texte après une mise à jour du site. Un test détecte ce changement avant qu’il ne fausse les rapports de marge.
Orchestration, logs et idempotence
Quand plusieurs flux dépendent les uns des autres, un outil d’orchestration planifie leur exécution, suit leur état et déclenche les tâches dans le bon ordre. Apache Airflow est une option souvent utilisée pour modéliser ces dépendances, mais le choix d’un outil doit rester proportionné à la complexité réelle. Pour quelques transferts simples, une plateforme gérée peut demander moins de maintenance qu’une infrastructure développée sur mesure.
Les journaux d’exécution doivent indiquer le début et la fin des tâches, le nombre de lignes traitées et les erreurs rencontrées. L’idempotence est un autre garde-fou important : relancer le même traitement ne doit pas créer de doublons ni modifier incorrectement l’historique. Cette propriété s’obtient grâce à des clés stables, des mises à jour contrôlées et des chargements conçus pour être rejouables. La reprise après incident fait partie du fonctionnement normal d’un pipeline, pas d’un scénario exceptionnel.
Batch, micro-batch ou streaming : trouver le bon rythme de traitement
La fréquence d’actualisation influence la complexité, les coûts et l’utilité des données. Toutes les décisions ne nécessitent pas une mise à jour à la milliseconde. Un bilan comptable hebdomadaire peut être parfaitement fiable avec un traitement nocturne, tandis qu’une alerte de fraude doit parfois arriver bien plus vite. Le bon rythme part du besoin métier, pas de la promesse technique du temps réel.
Le batch pour les traitements planifiés
Le batch regroupe les informations et les traite à des horaires définis : chaque nuit, chaque heure ou une fois par semaine. Cette approche convient aux rapports financiers, aux analyses de ventes et à de nombreux tableaux de bord internes. Elle permet de lancer les calculs à des moments prévisibles et de concentrer la surveillance sur des fenêtres de traitement clairement identifiées.
Atelier Nord peut consolider chaque nuit les ventes, les remboursements et les dépenses publicitaires de la veille. Les équipes marketing disposent alors d’une vue cohérente le matin, sans qu’un flux continu soit nécessaire. La limite est connue : une décision prise à midi s’appuie sur des données qui peuvent dater de plusieurs heures. Si ce décalage ne change pas l’action à prendre, le streaming n’apporte pas automatiquement de valeur.
Le micro-batch comme compromis
Le micro-batch exécute de petites tâches à intervalles rapprochés, par exemple toutes les quinze minutes. Il réduit le délai sans exiger une architecture entièrement événementielle. Pour un site marchand, cette fréquence peut suffire à mettre à jour les niveaux de stock ou à repérer une hausse inhabituelle des commandes au cours de la journée.
Ce compromis facilite parfois l’adoption progressive. Une équipe peut commencer par des exécutions planifiées, mesurer le délai acceptable, puis raccourcir les intervalles si un besoin réel apparaît. Il faut toutefois surveiller la charge créée par la fréquence : lancer trop souvent des traitements lourds peut consommer des ressources sans améliorer la décision. Mesurer la latence utile est plus pertinent que viser un chiffre spectaculaire.
Le streaming lorsque chaque événement compte
Le streaming traite les événements au fil de leur arrivée. Il est adapté aux alertes de fraude, au suivi de capteurs industriels ou à certaines opérations logistiques où un retard peut entraîner une perte concrète. Il demande en général davantage de surveillance, une gestion soigneuse des événements reçus en double et une stratégie pour traiter les retards ou les interruptions.
Si Atelier Nord veut signaler instantanément une série de paiements suspects, un flux continu peut être justifié. Pour calculer le panier moyen mensuel, il ne l’est probablement pas. Une architecture peut aussi combiner les modes : streaming pour les alertes critiques, batch pour les analyses historiques. Le temps réel est une exigence métier à démontrer, pas un label à ajouter à une présentation.
Outils ETL, coûts et bonnes pratiques pour un système durable
Le marché propose des plateformes avec connecteurs préconstruits, des services cloud gérés et des outils open source. Talend, Fivetran et Stitch illustrent différentes options de connexion et de transfert, tandis qu’Apache Airflow sert notamment à orchestrer des tâches. Les fonctionnalités, tarifs et offres évoluent : avant de choisir, il faut vérifier les conditions actuelles, les connecteurs disponibles et le modèle de facturation.
Comparer les outils selon le travail à accomplir
Une solution gérée peut accélérer la connexion à des services SaaS populaires et réduire le code à maintenir. Elle est souvent intéressante lorsque les sources sont standardisées et que le temps de déploiement compte. En revanche, les coûts peuvent évoluer avec le volume, la fréquence des synchronisations ou le nombre de connecteurs. Il faut estimer la dépense sur un scénario réaliste, pas seulement comparer les tarifs d’entrée.
Le développement sur mesure convient lorsque les sources sont spécifiques, que les règles sont complexes ou que l’entreprise doit garder un contrôle précis sur ses traitements. Il évite certaines limites de connecteurs, mais exige des compétences de développement, des tests et une maintenance durable. Le code écrit aujourd’hui devra être compris demain, y compris après un changement d’équipe. Une solution gratuite à l’installation peut coûter cher si chaque incident nécessite plusieurs jours d’intervention.
Surveiller la qualité et le coût du pipeline
Un suivi utile combine des indicateurs techniques et métier : taux d’échec, retard de mise à jour, volume extrait, lignes rejetées, coût de calcul et fraîcheur des données. Si un flux censé terminer avant l’ouverture des bureaux arrive régulièrement en retard, le problème a un impact opérationnel, même si le traitement finit par réussir. Des alertes bien réglées aident à distinguer une vraie anomalie d’une variation normale.
Il faut également prévoir la sécurité : droits d’accès limités, secrets protégés, données sensibles conservées uniquement si elles sont nécessaires et durées de rétention définies. Dans une architecture plus large, la circulation entre applications mérite une réflexion globale sur l’intégration des systèmes et des données. Ces décisions évitent de multiplier les copies opaques et rendent les responsabilités plus claires.
Une méthode simple pour démarrer sans surconstruire
- Partir d’une décision à améliorer : définir qui utilisera les données et quelle action dépendra du résultat.
- Cartographier les sources : repérer les propriétaires, les formats, les fréquences de mise à jour et les restrictions d’accès.
- Construire un flux limité : commencer par un indicateur utile, tester l’extraction et documenter les transformations.
- Ajouter des contrôles : vérifier les schémas, les doublons, les valeurs manquantes et les écarts inhabituels.
- Mesurer avant d’étendre : observer la fiabilité, le délai et le coût avant de connecter d’autres outils.
Cette progression évite de créer une architecture impressionnante mais difficile à exploiter. Une petite entreprise peut commencer avec un transfert quotidien et quelques tests, puis renforcer l’orchestration lorsque les dépendances augmentent. Une organisation plus complexe aura besoin de règles de gouvernance et de supervision plus poussées dès le départ. Un pipeline durable est celui dont les résultats sont compris, contrôlés et utilisés.
Questions fréquentes sur l’ETL en informatique
Que signifie ETL en informatique ?
ETL signifie extraire, transformer et charger. Le processus récupère des données depuis différentes sources, les rend cohérentes au moyen de règles définies, puis les charge dans une destination exploitable, comme un entrepôt de données.
Quelle est la différence entre ETL et ELT ?
Dans l’ETL, les données sont transformées avant leur chargement dans la destination finale. Dans l’ELT, elles sont chargées d’abord, puis transformées dans la plateforme de destination. Le choix dépend notamment de l’infrastructure, de la sécurité et des besoins de calcul.
Un pipeline ETL doit-il fonctionner en temps réel ?
Non. Le batch suffit pour de nombreux rapports périodiques. Le streaming se justifie lorsque le délai de traitement influence directement une action, par exemple pour une alerte de fraude ou un suivi opérationnel urgent.
Quels contrôles rendent un pipeline ETL plus fiable ?
La validation des schémas, les tests de qualité, le suivi des erreurs, la journalisation et l’idempotence réduisent les risques. Ils permettent notamment de détecter des données mal formées et de relancer un traitement sans créer de doublons.