Un data lake et un entrepôt de données peuvent contenir les informations d’une même entreprise, mais ils ne les préparent pas de la même façon. Le premier conserve des données dans leur format d’origine, parfois avant même que leur usage soit connu. Le second organise des données nettoyées pour répondre rapidement à des questions métier précises. Cette différence influence les coûts, les outils, les compétences nécessaires et la fiabilité des analyses.
Pour une entreprise qui collecte des commandes, des clics, des fichiers, des images ou des mesures issues de capteurs, le choix n’est pas seulement technique. Il détermine comment les équipes pourront transformer ces informations en décisions, en prévisions ou en automatisations. Une architecture adaptée évite de payer pour traiter trop tôt des données inutiles, mais aussi de laisser s’accumuler des fichiers impossibles à exploiter. La bonne approche commence donc par une question simple : quelles décisions ces données doivent-elles aider à prendre ?
En bref
-
Data lake : stockage flexible de données brutes, structurées, semi-structurées ou non structurées.
-
Entrepôt de données : environnement organisé pour l’analyse, le reporting et les requêtes métier fiables.
-
Différence clé : le lac applique généralement un schéma à la lecture ; l’entrepôt définit la structure avant le chargement.
-
Usage courant : le lac convient à l’exploration et aux projets d’IA ou de machine learning ; l’entrepôt sert la BI et les tableaux de bord.
-
Choix pragmatique : de nombreuses organisations combinent ces systèmes ou adoptent progressivement une architecture lakehouse.
Data lake : définition d’un stockage de données brutes et flexible
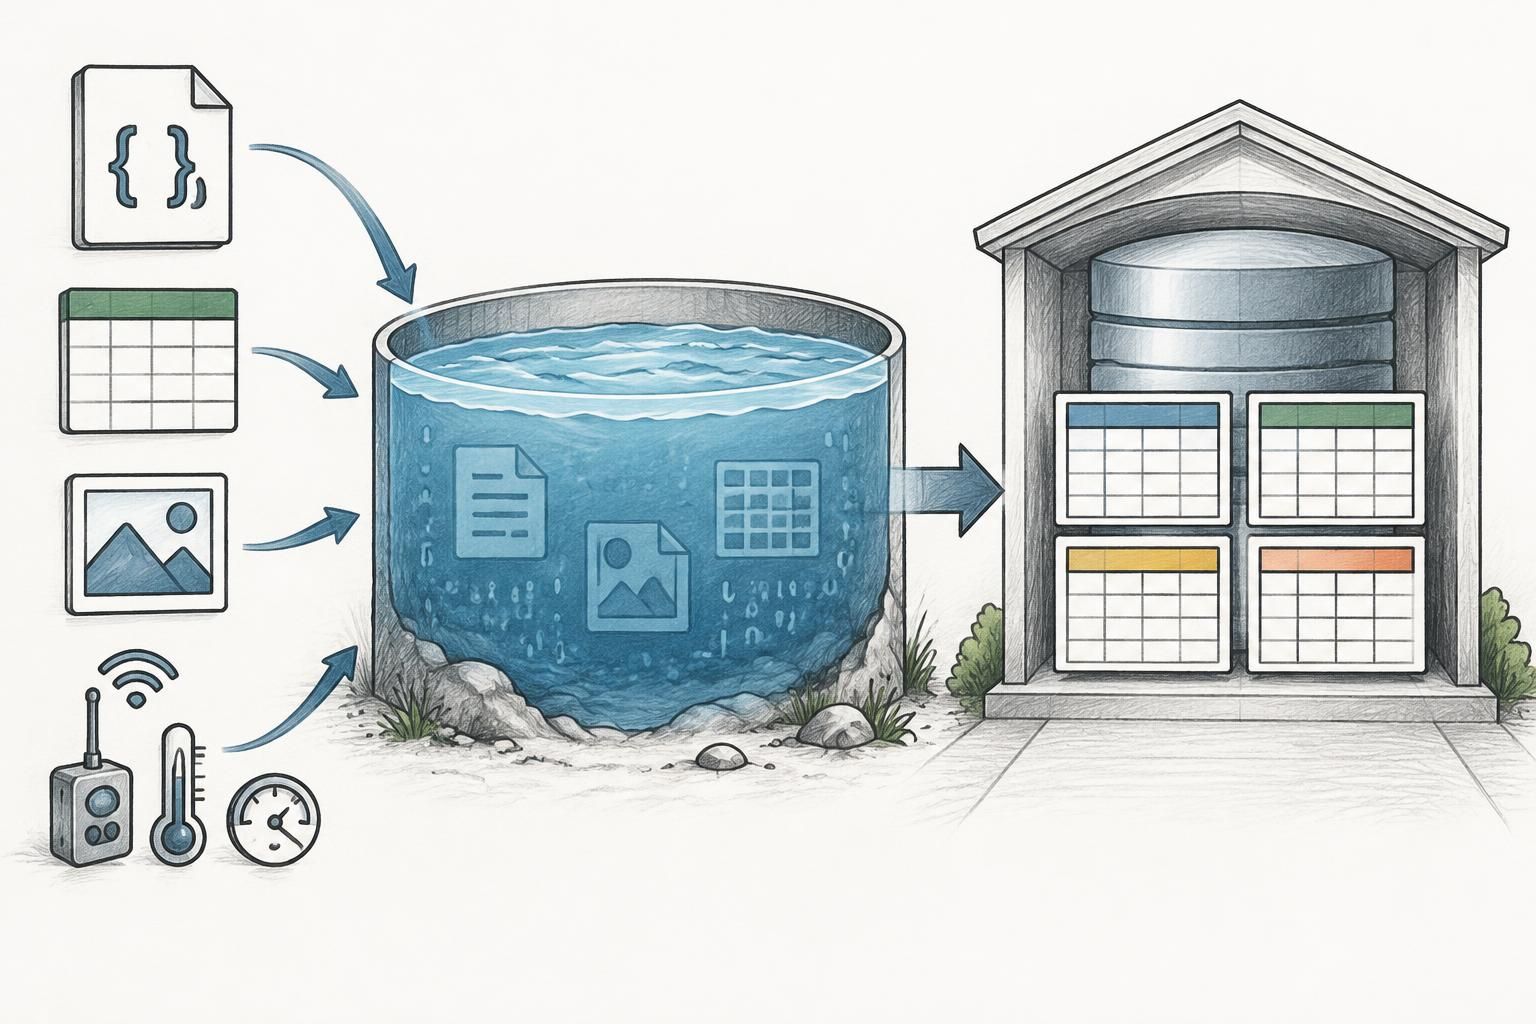
Un data lake, ou lac de données, est un espace centralisé conçu pour recevoir de grandes quantités d’informations dans leur format d’origine. Il peut contenir des tables issues d’une base métier, des fichiers JSON produits par une application, des journaux de navigation, des images, des documents ou des mesures de capteurs. Les données ne doivent pas toutes être transformées avant d’être stockées. C’est cette souplesse qui distingue le lac d’un système conçu uniquement pour le reporting.
Imaginez une plateforme de réservation qui suit les recherches, les clics, les paiements et les avis. Au lancement, l’équipe ne sait pas encore quels signaux permettront de prédire une annulation ou de personnaliser une offre. Elle peut conserver les événements bruts dans le lac, puis les analyser plus tard, lorsque de nouvelles questions apparaissent. Cette réserve d’informations évite de jeter des données qui pourraient devenir utiles à mesure que le produit évolue.
Le schéma à la lecture : structurer au moment de l’analyse
Dans un lac, la structure est souvent définie lorsque l’utilisateur consulte ou traite les données. Cette méthode est appelée schéma à la lecture. Elle permet d’ingérer rapidement des fichiers variés, sans devoir décider à l’avance de la forme exacte de chaque colonne. Les équipes techniques peuvent ensuite appliquer des règles différentes selon le besoin : créer un jeu d’entraînement pour un modèle, calculer des indicateurs ou rapprocher des événements provenant de plusieurs applications.
Cette liberté a toutefois un prix. Un fichier brut n’est pas automatiquement compréhensible ni fiable. Une date peut être enregistrée selon plusieurs formats, un identifiant peut manquer, et deux systèmes peuvent désigner différemment la même information. Sans catalogue, documentation et contrôles de qualité, le lac risque de devenir un « marécage de données » : un espace volumineux où personne ne sait précisément ce que contiennent les fichiers. Une démarche de gouvernance des données aide à maintenir des définitions, des droits d’accès et des règles de conservation claires.
Pourquoi les data lakes sont utiles pour l’exploration
Les lacs sont souvent construits sur du stockage d’objets dans le cloud, qui sépare la capacité de stockage des ressources de calcul. Une organisation peut donc conserver beaucoup de données sans devoir dimensionner en permanence un moteur analytique coûteux. Des outils de traitement, comme Apache Spark, peuvent être connectés pour nettoyer ou transformer les fichiers lorsqu’un projet le justifie. Le coût réel dépend néanmoins du volume, des accès, des traitements et de la durée de conservation : « stockage peu coûteux » ne signifie pas « architecture sans frais ».
Cette organisation est pertinente pour l’analyse exploratoire, l’archivage, les données IoT et les projets d’IA. Pour repérer des signaux de fraude, par exemple, une équipe peut combiner les journaux d’un site, les événements d’une application et des données partenaires. Les informations brutes restent disponibles pour vérifier une anomalie ou réentraîner un modèle avec de nouveaux critères. Le data lake préserve la possibilité de poser demain une question qui n’existe pas encore.
Entrepôt de données : des informations préparées pour l’analyse métier
Un entrepôt de données, ou data warehouse, rassemble des informations provenant de différentes sources, les nettoie et les organise pour faciliter les analyses. Les données chargées sont généralement structurées selon un modèle défini : tables, colonnes, identifiants et règles de cohérence. Cette préparation permet aux équipes de consulter des indicateurs comparables dans le temps et d’obtenir des résultats reproductibles. L’entrepôt est particulièrement adapté à la business intelligence, aux rapports de gestion et aux tableaux de bord.
Reprenons l’exemple d’un détaillant. Ses commandes proviennent de boutiques, d’un site web et d’une application. Avant leur intégration dans l’entrepôt, les adresses peuvent être normalisées, les taxes calculées et les références produits rapprochées. Une responsable peut ensuite demander combien de chemises bleues ont été vendues à Lyon durant le trimestre, sans avoir à examiner manuellement chaque fichier de commande. Les données sont préparées pour répondre à une question métier concrète.
Le schéma à l’écriture rend les résultats cohérents
La méthode courante de l’entrepôt est le schéma à l’écriture : la structure et les règles sont appliquées avant ou pendant le chargement. Cette étape peut demander du travail. Il faut comprendre les sources, décider des définitions communes et transformer les données pour les rendre compatibles. En contrepartie, les utilisateurs disposent de tables plus fiables et peuvent s’appuyer sur des requêtes SQL pour produire des analyses rapidement.
Cette cohérence devient essentielle lorsqu’une entreprise veut comparer des ventes, suivre la marge ou piloter une campagne. Si chaque équipe calcule le chiffre d’affaires avec une définition différente, les tableaux de bord se contredisent. Un entrepôt bien conçu centralise les règles de calcul et rend les indicateurs plus faciles à partager. Il constitue souvent une pièce importante d’une stratégie visant à devenir une entreprise pilotée par la donnée, où les décisions reposent sur des métriques comprises par tous.
Des performances utiles au reporting et à la BI
Une architecture classique d’entrepôt comprend une couche d’ingestion et de transformation, un moteur analytique, puis des outils de consultation et de visualisation. Les pipelines ETL extraient les données, les transforment, puis les chargent dans leur destination. Des solutions modernes peuvent aussi proposer des traitements plus souples ou fonctionner dans le cloud, mais le principe reste le même : fournir un jeu de données exploitable, plutôt qu’un ensemble de fichiers bruts.
Une banque, par exemple, a besoin de consolider les transactions pour calculer les soldes, produire des rapports et suivre des indicateurs réglementaires. Elle doit appliquer des règles précises et retracer la provenance des chiffres. Un entrepôt facilite ces usages, à condition que les données soient correctement contrôlées et que les accès soient adaptés à la sensibilité des informations. Les outils de gestion d’un data warehouse s’intègrent ainsi à une démarche plus large de qualité et de sécurité.
La préparation préalable peut ralentir l’accès à une nouvelle source et mobiliser des ingénieurs. Les systèmes traditionnels peuvent aussi devenir coûteux lorsqu’ils associent étroitement stockage et calcul ou lorsque les requêtes sont mal optimisées. Mais pour des rapports récurrents, ce travail en amont réduit les ambiguïtés et accélère les usages quotidiens. L’entrepôt échange une partie de la flexibilité du lac contre des données prêtes à décider.
Data lake ou entrepôt de données : les différences concrètes
La différence entre un data lake et un entrepôt de données ne se résume pas à la quantité d’informations stockée. Elle concerne surtout le moment où les données sont structurées, les profils qui les utilisent et le type de résultats attendu. Le lac accueille des contenus variés sans imposer immédiatement un modèle unique. L’entrepôt privilégie des jeux de données préparés, adaptés à des questions récurrentes et à des indicateurs partagés.
Le tableau ci-dessous donne des repères pratiques. Les frontières évoluent toutefois : les entrepôts modernes peuvent traiter certains formats semi-structurés, et les lacs peuvent être complétés par des catalogues ou des couches analytiques. Il faut donc comparer les usages réels et les fonctionnalités de chaque plateforme, plutôt que se fier uniquement à son étiquette commerciale.
| Critère | Data lake | Entrepôt de données |
|---|---|---|
| Type de données | Données brutes, structurées, semi-structurées et non structurées | Données principalement nettoyées et structurées |
| Structure | Schéma défini souvent à la lecture | Schéma défini avant ou pendant le chargement |
| Objectif | Stockage flexible, exploration, traitement avancé | Reporting, BI, indicateurs et analyses récurrentes |
| Utilisateurs fréquents | Ingénieurs de données, data scientists | Analystes métier, équipes BI, responsables opérationnels |
| Atout principal | Flexibilité et prise en charge de formats variés | Cohérence des données et requêtes analytiques rapides |
| Point de vigilance | Gouvernance, documentation et qualité à organiser | Préparation préalable et évolution du modèle à gérer |
Un exemple : analyser les ventes et les comportements
Une boutique en ligne peut verser dans son lac les événements de navigation, les fichiers de support, les avis clients et les commandes brutes. Une équipe data science explore ces informations pour chercher des signes de désabonnement ou tester un système de recommandation. Les formats ne sont pas identiques, et leur intérêt peut apparaître seulement après plusieurs essais. Le lac permet de conserver une trace détaillée avant d’avoir défini tous les usages.
Les ventes destinées au tableau de bord suivent un autre parcours. Les commandes sont nettoyées, les produits rapprochés d’un référentiel commun et les remboursements pris en compte. Les données préparées sont chargées dans l’entrepôt, où les responsables peuvent suivre le chiffre d’affaires par canal ou comparer les périodes. Un outil de visualisation des données peut ensuite rendre ces résultats lisibles, mais il ne corrige pas une définition incohérente des indicateurs à la source.
Le coût se mesure au-delà du stockage
Le lac peut coûter moins cher pour conserver de grands volumes, notamment lorsque les données sont peu consultées. Pourtant, il faut aussi financer l’ingestion, les traitements, les catalogues, les contrôles d’accès et les compétences nécessaires pour exploiter les fichiers. À l’inverse, l’entrepôt peut demander un investissement important dans la transformation et la modélisation, mais simplifier le travail des équipes qui produisent des rapports réguliers.
Une petite entreprise qui suit uniquement ses ventes mensuelles n’a pas forcément besoin d’une architecture complexe à deux systèmes. Un entrepôt cloud ou une solution analytique simple peut suffire. Une plateforme numérique qui reçoit des millions d’événements, utilise des données non structurées et entraîne des modèles aura probablement d’autres besoins. Le meilleur système n’est pas celui qui stocke tout : c’est celui qui rend les données utiles à un coût et à un niveau de complexité maîtrisés.
Cas d’usage : quand choisir un lac, un entrepôt ou les deux
Le choix devient plus clair lorsqu’il part d’un cas d’usage et d’une question opérationnelle. Cherchez-vous à conserver des données pour une analyse future, ou à fournir chaque matin un tableau de bord fiable aux équipes ? Avez-vous besoin d’examiner des images, des textes et des événements d’application, ou surtout de comparer des ventes, des prix et des dates ? Ces réponses indiquent le type de préparation nécessaire et les profils qui devront intervenir.
Le lac pour l’IA, l’IoT et l’exploration
Une entreprise qui déploie des capteurs dans ses équipements peut enregistrer leurs mesures à intervalles rapprochés dans un lac. Elle conserve ainsi l’historique, y compris les périodes où aucun incident n’a été détecté. Plus tard, les ingénieurs peuvent rapprocher les signaux de température, de vibration et de maintenance pour chercher les conditions qui précèdent une panne. Le format d’origine et le volume rendent le stockage flexible particulièrement utile.
Le même principe s’applique à un modèle de détection de fraude. Les événements d’un site, les journaux d’une application et les informations de partenaires peuvent être regroupés dans un espace commun. Une équipe transforme ensuite ces sources pour entraîner et tester un modèle. Si elle découvre qu’un détail jusque-là ignoré améliore la détection, elle peut revenir aux données originales. Les projets d’IA bénéficient de cette profondeur, mais ils exigent aussi des règles de confidentialité, une documentation et des contrôles de qualité.
Dans l’industrie, les données des machines peuvent aider à planifier la maintenance et à repérer des dérives de production. Le lac peut conserver des mesures détaillées tandis que des traitements produisent des indicateurs destinés aux équipes. L’enjeu n’est pas de collecter chaque signal pour le principe : il faut préciser la durée de conservation, les usages prévus et le coût des traitements. Un projet lié à l’industrie 4.0 gagne à relier les données techniques à une décision opérationnelle mesurable.
L’entrepôt pour le pilotage régulier
Pour prévoir les ventes du mois prochain, un distributeur peut s’appuyer sur un entrepôt contenant des historiques déjà nettoyés : dates, références produit, prix, quantités et promotions. Une requête SQL rassemble les périodes comparables, puis les résultats alimentent une prévision ou un tableau de bord. Les analystes peuvent tester plusieurs hypothèses sans recommencer à nettoyer chaque fichier à la main.
Les équipes marketing et finance profitent également d’indicateurs communs. Elles peuvent comparer le coût d’acquisition, le chiffre d’affaires et les retours selon les mêmes règles. Cette cohérence est utile pour évaluer le ROI d’une campagne ou ajuster un budget. Elle suppose toutefois que les définitions soient documentées : par exemple, préciser si le chiffre d’affaires inclut les commandes annulées ou les remboursements.
Combiner les systèmes sans créer deux silos
Beaucoup d’organisations utilisent les deux approches. Les nouvelles données arrivent dans un lac, puis les jeux utiles aux activités quotidiennes sont transformés et publiés dans un ou plusieurs entrepôts. Une équipe peut garder les données détaillées pour l’analyse exploratoire, tout en donnant aux responsables des tables fiables et faciles à interroger. Cette organisation nécessite des pipelines suivis, des règles de nommage et une responsabilité claire sur chaque jeu de données.
Sans ces règles, la combinaison entraîne des copies multiples, des chiffres contradictoires et des coûts difficiles à prévoir. Il faut donc préciser quelle plateforme fait foi pour chaque indicateur et comment une modification se répercute dans les rapports. Une architecture de données efficace ressemble moins à une collection d’outils qu’à une chaîne de production où chaque étape a une fonction définie. Le bon cas d’usage guide l’architecture ; l’inverse finit souvent par produire de la complexité inutilisée.
Data lakehouse et gouvernance : construire une architecture durable
Le data lakehouse cherche à rapprocher la flexibilité du lac et les capacités analytiques de l’entrepôt. Il s’appuie généralement sur un stockage de type lac, auquel s’ajoutent des métadonnées, des règles de gouvernance et des fonctions qui améliorent les requêtes et la fiabilité. L’objectif est de travailler sur différents types de données dans un environnement plus unifié, sans imposer systématiquement une copie vers un entrepôt séparé.
Ce que le lakehouse apporte aux équipes
Une couche de métadonnées peut cataloguer les fichiers, accélérer leur recherche et appliquer des règles de schéma ou de qualité. Des formats ouverts et des technologies de table, comme Apache Iceberg ou Delta Lake, peuvent ajouter des fonctions de gestion des versions et de transactions. Certaines implémentations prennent en charge des garanties transactionnelles de type ACID, utiles pour préserver la cohérence lors d’écritures concurrentes ou de mises à jour. Les possibilités précises dépendent toutefois de la plateforme et de son implémentation.
Pour une équipe qui entraîne des modèles, l’intérêt est de rapprocher les données de travail des outils d’analyse. Pour une équipe BI, des tables contrôlées et des moteurs SQL peuvent réduire les détours entre les fichiers bruts et les indicateurs. Le lakehouse n’élimine pas automatiquement les besoins d’ingénierie : il faut toujours définir les droits, surveiller les traitements, comprendre les formats et vérifier les performances. La technologie simplifie certains workflows, pas la responsabilité de bien gérer les données.
Éviter le marécage de données
Un lac sans catalogue ressemble à une bibliothèque où les livres seraient empilés sans titre, sans classement et sans indication d’auteur. Les données existent, mais leur découverte devient lente et leur interprétation risquée. Il faut documenter les jeux disponibles, leur origine, leur propriétaire, leur fraîcheur et les transformations qu’ils ont subies. Les règles d’accès doivent aussi tenir compte des données personnelles, commerciales ou sensibles.
La qualité ne se limite pas à retirer les valeurs vides. Elle consiste à vérifier que les données sont adaptées à un usage : cohérence des identifiants, plages de valeurs plausibles, fraîcheur suffisante et rapprochement correct entre sources. Un indicateur affiché dans un tableau de bord doit pouvoir être expliqué et reproduit. La gouvernance rend ce contrôle praticable, surtout lorsque plusieurs équipes utilisent les mêmes informations.
Moderniser progressivement plutôt que tout remplacer
Une organisation qui possède déjà un lac et un entrepôt n’a pas nécessairement intérêt à les démanteler. Elle peut commencer par un cas d’usage limité : réunir certaines tables, tester un format ouvert ou offrir un accès analytique aux données déjà stockées. Cette progression permet de comparer les coûts, la qualité des résultats et l’effort de migration avant d’étendre l’approche.
Avant de choisir une plateforme, cartographiez les sources, les utilisateurs et les décisions à soutenir. Identifiez aussi les délais de mise à jour, les exigences de sécurité, les volumes prévisibles et les compétences disponibles. Une démarche de data management en entreprise aide à relier ces éléments au fonctionnement réel des équipes. Une architecture durable n’est pas la plus moderne sur le papier : c’est celle que les équipes peuvent gouverner, comprendre et faire évoluer.
Choisir entre data lake et entrepôt de données : une méthode simple
Pour décider, partez des questions que les équipes doivent résoudre, puis remontez vers les données nécessaires. Si le besoin principal est un reporting stable avec des indicateurs partagés, l’entrepôt est souvent le point de départ le plus direct. Si l’objectif est de conserver des formats variés, d’explorer des données encore peu connues ou de soutenir des modèles de machine learning, le lac apporte davantage de latitude. Quand les deux besoins sont réels, une architecture combinée ou un lakehouse mérite d’être évalué.
Établir un premier périmètre utile
Il est tentant de vouloir réunir toutes les sources dès le premier jour. Cette ambition peut retarder le projet et faire grimper les coûts avant qu’un résultat soit visible. Choisissez plutôt une décision importante, par exemple réduire les ruptures de stock, mieux attribuer les ventes ou repérer des anomalies de paiement. Définissez l’indicateur qui montrera si le projet fonctionne et les données réellement nécessaires pour le calculer.
Ensuite, vérifiez leur qualité et leur disponibilité. Où se trouvent-elles ? Qui peut les valider ? À quelle fréquence arrivent-elles ? Quelle règle s’applique en cas de valeurs manquantes ? Ces questions paraissent moins spectaculaires qu’un choix de plateforme, mais elles évitent de construire un pipeline automatisé qui produit des chiffres faux à grande vitesse. L’automatisation sans compréhension ne fait qu’accélérer les erreurs.
Comparer les coûts, les accès et les compétences
Un lac demande souvent des compétences de traitement et de gouvernance, car la souplesse de stockage ne rend pas les données prêtes à l’emploi. Un entrepôt sollicite davantage les équipes lors de la modélisation et de la transformation, mais il peut simplifier l’accès SQL pour les analystes. Pour chaque option, estimez non seulement le stockage, mais aussi les traitements, les requêtes, la supervision, la sécurité et le temps passé par les équipes.
La facilité d’utilisation compte aussi. Si les responsables métier doivent consulter des chiffres chaque semaine, un environnement bien structuré et relié à des outils de BI peut accélérer l’adoption. Si des data scientists doivent tester des formats et construire des jeux d’entraînement, une solution qui conserve les sources brutes évite des contraintes prématurées. Le bon choix tient compte de ceux qui utiliseront les données, pas seulement de ceux qui les administrent.
Tester avant de généraliser
Un pilote réduit le risque. Prenez un flux de données représentatif, définissez un objectif mesurable et suivez les coûts ainsi que la qualité des résultats. Par exemple, une équipe e-commerce peut comparer le temps nécessaire pour produire un rapport de vente dans un entrepôt avec celui requis pour analyser des événements de navigation dans un lac. Les deux tests ne répondent pas à la même question : c’est précisément ce qui permet de clarifier le rôle de chaque système.
À la fin du pilote, documentez ce qui fonctionne et ce qui reste manuel. Vérifiez si les utilisateurs comprennent les définitions, si les données arrivent à temps et si les droits d’accès sont adaptés. Puis décidez d’étendre, de corriger ou d’abandonner le dispositif. Une architecture de données se valide par des usages réels et des résultats mesurables, pas par une promesse de plateforme.
Quelle est la différence principale entre un data lake et un entrepôt de données ?
Le data lake conserve généralement les données dans leur format d’origine et permet de définir leur structure au moment de l’analyse. L’entrepôt stocke des données préalablement nettoyées et organisées pour produire des rapports et des requêtes métier fiables.
Un data lake est-il réservé aux projets d’intelligence artificielle ?
Non. Il peut aussi servir à l’archivage, à l’exploration, au stockage de données IoT ou à la conservation de fichiers variés. L’IA et le machine learning sont des usages fréquents, mais ils ne justifient pas à eux seuls la création d’un lac.
Une entreprise peut-elle utiliser un lac et un entrepôt en même temps ?
Oui. Une organisation peut conserver les données brutes dans un lac, puis préparer les jeux nécessaires aux rapports dans un entrepôt. Elle doit toutefois éviter les copies incontrôlées et définir clairement la source de référence pour chaque indicateur.
Qu’est-ce qu’un data lakehouse ?
Un lakehouse combine le stockage flexible associé aux lacs avec des fonctions de catalogue, de gouvernance et d’analyse qui rapprochent l’expérience de celle d’un entrepôt. Ses capacités varient selon les technologies et la plateforme retenues.
Comment choisir la solution adaptée à son projet ?
Commencez par préciser les décisions à soutenir, les formats de données, les utilisateurs et les exigences de mise à jour. Un entrepôt convient souvent aux rapports récurrents ; un lac à l’exploration et aux données variées. Un pilote permet de vérifier les coûts et les résultats avant d’élargir l’architecture.