Un comité CAB ITIL utile ne valide pas mécaniquement chaque ticket : il aide l’organisation à changer sans perdre la maîtrise de ses services. Son rôle consiste à réunir les bons points de vue, à repérer les risques invisibles pour une seule équipe et à conseiller le responsable du changement. Dans une DSI qui déploie souvent, cette nuance est décisive. Un comité trop lourd ralentit les équipes ; un comité bien conçu réserve l’examen collectif aux changements qui le justifient.
La bonne question n’est donc pas « faut-il un CAB ? », mais « quelles décisions gagnent réellement à être préparées ensemble ? ». Entre changements standard préapprouvés, transformations majeures et urgences, les règles doivent être adaptées au risque et au contexte métier. Le CAB moderne ne se contente pas de dire oui ou non : il contribue à rendre les déploiements plus prévisibles, plus transparents et mieux alignés sur les objectifs de l’organisation.
En bref
- Le CAB est consultatif : le gestionnaire des changements conserve généralement la responsabilité de la décision finale.
- Il évalue les risques, les dépendances, le calendrier, les ressources et les effets sur les utilisateurs.
- Les changements standard à faible risque peuvent être préapprouvés selon des critères documentés.
- Un ECAB traite les situations urgentes avec une procédure accélérée et une revue après mise en œuvre.
- L’automatisation et les tests facilitent les décisions, mais ne remplacent pas le jugement humain pour les changements sensibles.
Le rôle du CAB ITIL : conseiller sans devenir un goulot d’étranglement
Le sigle CAB vient de l’anglais Change Advisory Board, que l’on traduit par comité consultatif des changements. Ce point de vocabulaire compte : le CAB apporte une expertise collective, mais n’est pas nécessairement l’instance qui détient l’autorité finale d’approbation. Dans une organisation, cette responsabilité revient souvent au gestionnaire du changement ou à une personne explicitement désignée dans le processus.
Concrètement, le comité examine les changements qui méritent plusieurs regards. Il peut s’agir d’une migration de base de données, d’une modification d’architecture réseau ou d’une mise à jour touchant un service essentiel. Les membres cherchent à comprendre ce qui change, pourquoi, à quel moment, avec quels moyens de retour arrière et quelles conséquences possibles pour les équipes et les clients.
Imaginez une entreprise de commerce en ligne qui prévoit de modifier son système de paiement. L’équipe applicative connaît le code, mais ne voit pas toujours les contraintes de l’équipe support, les obligations de sécurité ou le calendrier d’une campagne commerciale. Le CAB met ces informations dans la même discussion. Il peut recommander de décaler le déploiement, de réaliser un test supplémentaire ou de procéder d’abord sur une partie du trafic.
Un examen collectif, pas une signature automatique
Le comité n’a pas besoin de relire chaque changement mineur. Si la modification est fréquente, documentée, testée et associée à un risque faible, un processus standard peut suffire. À l’inverse, une opération qui touche plusieurs services ou des données sensibles mérite une analyse plus poussée. Le niveau de gouvernance doit suivre le niveau de risque, pas le nombre de formulaires à remplir.
Cette logique rejoint les pratiques ITIL, qui donnent un cadre à la gestion des services sans imposer une réunion pour chaque intervention. Pour mieux situer ces pratiques dans une petite structure, le guide sur les normes ITIL adaptées aux petites DSI permet de réfléchir à une gouvernance proportionnée aux moyens disponibles.
Des profils complémentaires autour de la table
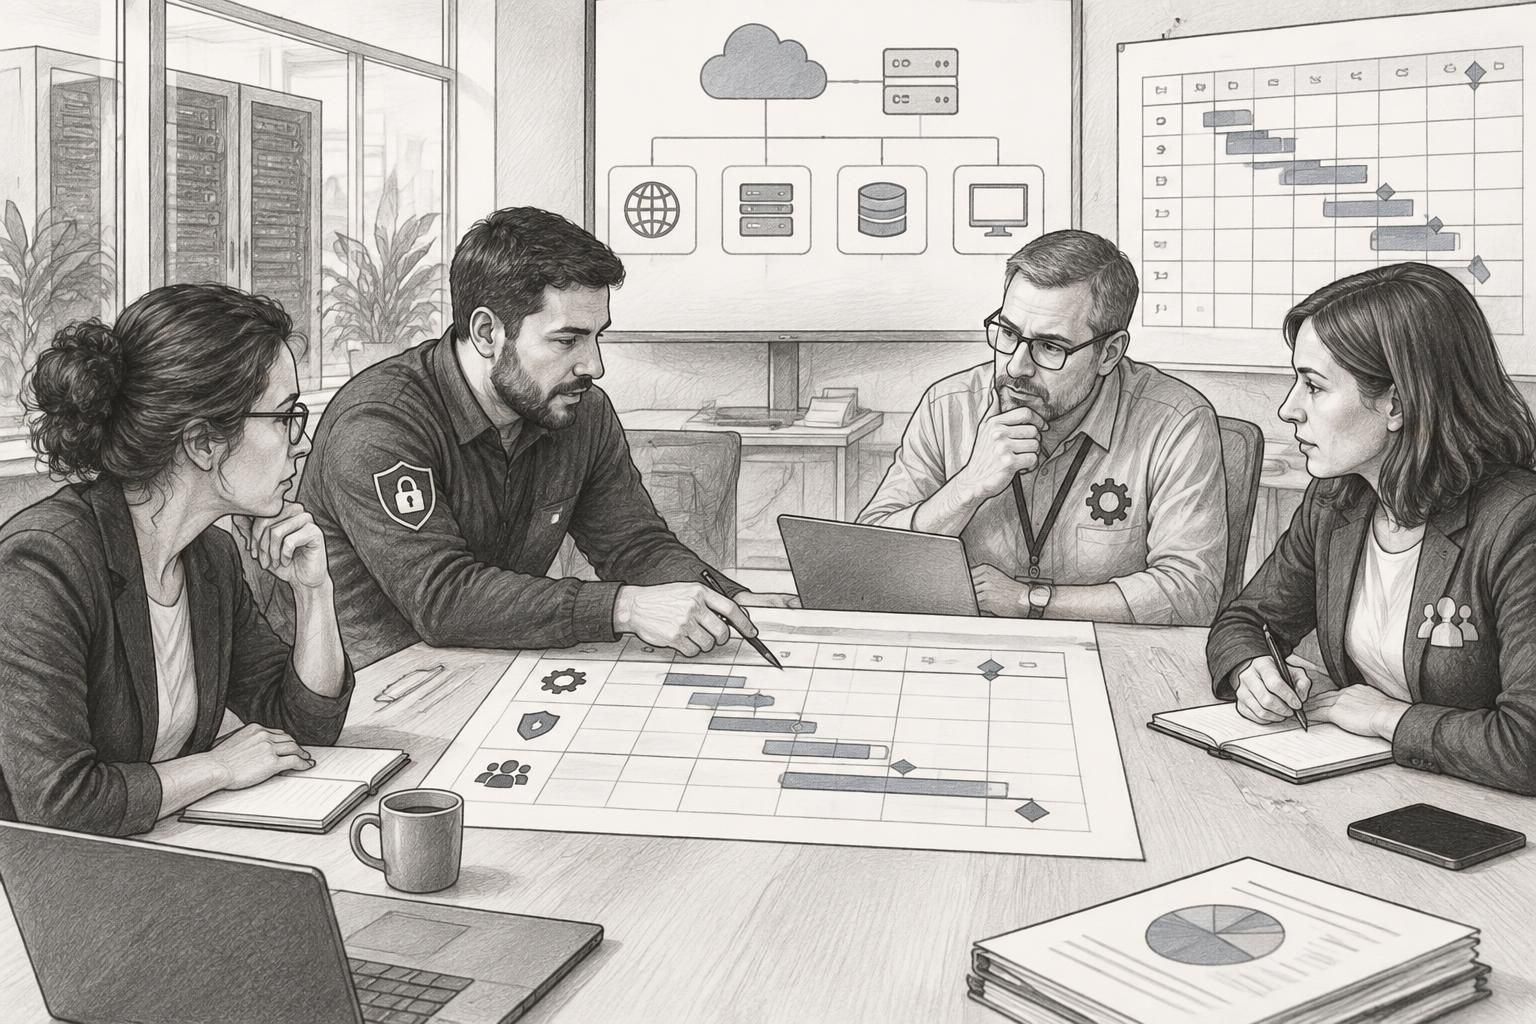
La composition varie selon le changement. Un responsable des opérations évalue la disponibilité et les procédures d’exploitation. Un spécialiste de l’application connaît les dépendances techniques. Le service desk anticipe les questions des utilisateurs, tandis que la sécurité vérifie les accès, les données et les contrôles. Un représentant métier peut préciser les périodes sensibles ou la valeur attendue.
Il n’est pas nécessaire de réunir tous ces profils à chaque fois. Une liste de membres permanents, complétée par des experts invités selon le sujet, évite les réunions surdimensionnées. Le CAB est efficace lorsque chaque participant apporte une information utile et que son avis influence réellement la recommandation. Sa valeur se mesure à la qualité des décisions, pas au nombre de personnes présentes.
Insight clé : le CAB sert à éclairer une décision avec les bonnes compétences ; il ne devrait pas transformer chaque changement en parcours administratif.
Comment le comité de validation des changements évalue une demande
Une réunion CAB utile commence avant la réunion. Une demande mal documentée oblige les participants à deviner le périmètre ou à reporter leur avis. Le demandeur doit expliquer le problème traité, le résultat attendu, les services concernés, les dépendances connues, le calendrier et les moyens prévus pour vérifier le succès. Sans ces éléments, le comité ne peut pas distinguer un risque maîtrisé d’un angle mort.
La justification métier mérite autant d’attention que le détail technique. Une mise à jour peut être parfaitement réalisable et pourtant mal programmée si elle tombe au milieu d’une clôture comptable ou d’une période de forte activité. Le CAB doit donc regarder les effets sur les utilisateurs et les objectifs opérationnels, plutôt que de se limiter à la question « est-ce que le code fonctionne ? ».
Les critères qui rendent l’analyse concrète
Pour structurer l’examen, les membres peuvent s’appuyer sur quelques critères communs. Cela rend les décisions plus comparables et évite que le résultat dépende uniquement de la personne qui préside la réunion. Un modèle de demande n’a pas besoin d’être complexe : il doit surtout faire ressortir les informations qui changent la décision.
| Critère | Question à poser | Exemple de preuve attendue |
|---|---|---|
| Impact métier | Quels services ou utilisateurs peuvent être touchés ? | Liste des services concernés et période d’activité sensible |
| Risque technique | Quelles défaillances sont plausibles ? | Analyse des dépendances et résultats de tests |
| Sécurité et conformité | Les accès ou données sont-ils modifiés ? | Validation sécurité et contrôle des exigences applicables |
| Mise en œuvre | Les équipes, ressources et fenêtres sont-elles disponibles ? | Plan d’intervention et responsables nommés |
| Retour arrière | Comment rétablir le service si le déploiement échoue ? | Procédure testable, déclencheurs et durée estimée |
Exemple : une migration qui semble simple
Une équipe veut déplacer une base de données vers une nouvelle infrastructure. Le plan initial indique une fenêtre nocturne et un test réussi. Le regard des opérations révèle toutefois qu’un traitement de facturation démarre juste après cette fenêtre. Le service desk signale que plusieurs applications partagent la base, tandis que la sécurité demande de vérifier les droits du nouvel environnement.
Le CAB peut recommander un test de charge, un déploiement par étapes et une confirmation de la sauvegarde restaurable avant le changement. Il peut aussi proposer un créneau moins risqué. Cette discussion n’est pas une formalité : elle transforme des informations dispersées en conditions d’exécution vérifiables.
La décision doit être traçable
À l’issue de l’examen, la recommandation peut être favorable, défavorable ou conditionnelle. Un report n’est pas nécessairement un rejet : il peut signifier que la demande doit être complétée, que les tests sont insuffisants ou que le calendrier crée un risque inutile. La justification doit être notée, avec les actions attendues, leur responsable et leur échéance.
Cette traçabilité sert à l’exploitation quotidienne, mais aussi aux audits et aux retours d’expérience après incident. Elle permet de comprendre pourquoi une décision a été prise au moment où elle l’a été. Un bon processus produit ainsi des décisions explicables, pas seulement des statuts dans un outil.
Insight clé : une demande de changement de qualité rend les risques discutables et les mesures de réduction contrôlables.
Changements standard, majeurs et urgents : adapter le niveau de contrôle
Traiter toutes les demandes de la même façon est l’une des erreurs les plus fréquentes. Une modification récurrente et bien maîtrisée ne présente pas le même profil qu’une migration majeure ou qu’un correctif de sécurité à appliquer rapidement. Un processus efficace répartit les changements selon leur nature, leur impact et leur incertitude. Cette classification évite à la fois la surveillance excessive et l’improvisation.
Les changements standard peuvent être préapprouvés
Un changement standard est généralement répétitif, documenté, à faible risque et déjà éprouvé. Par exemple, l’ajout d’un compte selon une procédure contrôlée ou le déploiement d’une mise à jour connue sur un groupe limité peut entrer dans cette catégorie, si les conditions sont respectées. La préapprobation ne signifie pas absence de contrôle : elle repose sur un modèle défini, des tests, des responsabilités et des critères d’arrêt.
Si une étape du modèle n’est pas remplie, la demande sort du parcours standard. Un déploiement habituel sur un serveur peut devenir inhabituel si la sauvegarde échoue, si l’environnement est différent ou si une dépendance vient d’être modifiée. Les équipes doivent pouvoir réorienter le changement vers une analyse renforcée au lieu de cocher les cases sans réfléchir.
Les changements normaux demandent une évaluation proportionnée
Les changements normaux sont examinés selon leur niveau de risque et leur portée. Certains peuvent être validés par le gestionnaire du changement après consultation ciblée ; d’autres nécessitent une discussion complète du CAB. La taille du projet n’est pas le seul indicateur : une petite modification d’authentification peut avoir plus d’impact qu’une opération technique plus vaste mais isolée.
Une matrice de risque aide à prioriser les dossiers, à condition de rester compréhensible. Elle peut combiner l’impact potentiel, la probabilité d’échec, la difficulté de retour arrière, le nombre de services dépendants et la sensibilité des données. Cette évaluation initiale sert à organiser le travail ; elle ne remplace pas l’expertise des personnes qui connaissent réellement le système.
L’ECAB pour les changements d’urgence
Un changement urgent ne peut pas toujours attendre la prochaine réunion. Un comité d’urgence, souvent appelé ECAB, réunit alors les personnes capables d’évaluer rapidement la situation : responsable du changement, expert technique, sécurité si nécessaire et représentant métier concerné. L’objectif est de réagir sans abandonner toute gouvernance.
En cas de vulnérabilité activement exploitée, par exemple, l’équipe peut devoir appliquer un correctif dans un délai court. L’ECAB vérifie le périmètre, les principaux risques et les moyens de restauration, puis consigne la décision. Après l’intervention, une revue examine le résultat, les incidents éventuels et les améliorations à apporter au processus d’urgence.
Un calendrier adapté au rythme réel
La fréquence des réunions dépend du volume et de la criticité des changements. Une entreprise qui déploie souvent peut organiser des revues courtes et fréquentes, tandis qu’une infrastructure plus stable se contente parfois de réunions périodiques et d’un dispositif d’urgence clair. Il n’existe pas de cadence universelle : c’est le délai entre la demande et la décision qui révèle si le fonctionnement est adapté.
Il est également utile de coordonner les opérations avec les périodes de forte activité, les maintenances prévues et les autres mises en production. Un calendrier partagé réduit les collisions. Il aide les équipes à anticiper au lieu de découvrir au dernier moment que deux changements importants ciblent le même service.
Insight clé : un contrôle pertinent est sélectif ; il concentre l’attention là où les conséquences d’un échec seraient les plus fortes.
La classification permet de gagner du temps, mais elle ne suffit pas si le comité se transforme en file d’attente. Les pratiques DevOps invitent à déplacer une partie du contrôle vers des règles, des tests et une surveillance continus.
Moderniser le CAB ITIL avec l’automatisation et les pratiques DevOps
Les équipes qui livrent fréquemment ont besoin d’un système capable de distinguer un changement maîtrisé d’une opération réellement risquée. Réunir un comité pour chaque petite mise à jour n’améliore pas automatiquement la fiabilité. Cela peut retarder des correctifs, accumuler les demandes et pousser des équipes frustrées à contourner le processus. La réponse n’est pas de supprimer toute gouvernance, mais d’en revoir le point d’application.
Automatiser les contrôles répétitifs
Les pipelines d’intégration et de déploiement continus peuvent exécuter des tests unitaires, des contrôles de sécurité, des vérifications de configuration et des validations de performance. Si les règles sont explicites, certaines demandes standard peuvent passer automatiquement lorsque les critères sont remplis. Le CAB définit alors les garde-fous et examine les exceptions plutôt que de vérifier manuellement chaque opération.
Par exemple, une équipe peut autoriser un déploiement progressif si les tests passent, si le taux d’erreur reste sous un seuil convenu et si le retour arrière est disponible. En cas d’anomalie, le système suspend le déploiement ou déclenche une restauration. L’automatisation accélère l’exécution, mais elle doit être accompagnée d’une supervision et d’une responsabilité clairement attribuées.
Utiliser les données de configuration pour voir les dépendances
Une base de données de gestion des configurations, ou CMDB, peut aider à identifier les relations entre applications, infrastructures et services. Si une modification concerne un composant partagé, l’équipe peut repérer plus tôt les systèmes susceptibles d’être touchés. La qualité de cette visibilité dépend toutefois de la mise à jour des informations : une CMDB obsolète donne une impression de précision sans garantir que la carte reflète la réalité.
Les outils ITSM centralisent aussi les demandes, les décisions, les calendriers et les actions de suivi. Ils facilitent les alertes et le reporting, mais ne rendent pas une analyse bonne par magie. Avant d’automatiser, il faut clarifier les catégories, les critères d’approbation et le parcours des exceptions. Automatiser un processus confus ne fait qu’accélérer la confusion.
Faire évoluer le comité vers un rôle de conseil
Un CAB moderne peut consacrer davantage de temps aux changements complexes, aux dépendances interéquipes et aux tendances observées dans les incidents. Il devient un lieu où l’on améliore les règles de déploiement et la capacité de retour arrière. Les membres peuvent aussi analyser les causes récurrentes d’échec pour déterminer si le problème vient d’un manque de test, d’une documentation faible ou d’une planification inadaptée.
Cette approche est compatible avec DevOps si le comité ne cherche pas à contrôler le travail quotidien des équipes. Il définit des limites acceptables, aide à rendre les risques visibles et favorise l’apprentissage. L’équilibre est important : la stabilité ne repose ni sur des signatures en chaîne ni sur la vitesse seule, mais sur la capacité à détecter rapidement un problème et à y répondre.
Insight clé : la technologie peut traiter les vérifications répétitives ; l’expertise humaine reste essentielle pour arbitrer les situations ambiguës et à fort impact.
Une fois les circuits clarifiés, reste à mesurer s’ils améliorent réellement la qualité des mises en production. Sans indicateurs et retours d’expérience, le comité risque de conserver des règles devenues inutiles ou de répéter les mêmes erreurs.
Mesurer l’efficacité du CAB et corriger ses points de friction
Un comité ne devient pas performant parce que ses réunions sont régulières. Il doit produire des décisions utiles, limiter les surprises et aider les équipes à livrer de manière maîtrisée. Les indicateurs apportent un repère, à condition de ne pas être utilisés comme des objectifs isolés. Un taux d’approbation élevé, par exemple, n’a aucun sens s’il s’accompagne de davantage d’incidents ou de changements mal documentés.
Suivre quelques indicateurs compréhensibles
Le taux de réussite des changements indique la part des déploiements qui atteignent leur objectif sans incident majeur ni retour arrière imprévu. Le délai de traitement mesure le temps entre la soumission d’une demande complète et la décision. Le nombre d’incidents associés aux changements aide à repérer les catégories ou les périodes qui nécessitent une attention particulière.
Il est également utile de suivre les changements d’urgence, les reports, les retours arrière et les actions correctives encore ouvertes. Ces données prennent de la valeur lorsqu’elles sont examinées ensemble. Une baisse du délai peut signaler un processus plus fluide, ou une analyse devenue trop légère ; le contexte et les résultats opérationnels permettent de distinguer les deux.
Repérer les symptômes d’un comité trop lourd
Des réunions qui s’allongent sans décision, des demandes reportées faute de documentation et des participants qui ne comprennent pas leur rôle sont des signaux d’alerte. Si des changements à faible risque mobilisent la même énergie que des transformations critiques, le modèle de classification est probablement à revoir. À l’inverse, des changements fréquents qui provoquent des incidents suggèrent que les critères de préapprobation ou les tests ne sont pas assez robustes.
Une revue trimestrielle peut examiner les délais, les incidents, les retours arrière et les commentaires des équipes. Elle sert à retirer les étapes qui n’apportent plus de valeur, mais aussi à renforcer celles qui préviennent un risque récurrent. Les règles doivent évoluer avec les services, les technologies et les obligations de l’organisation.
Faire de chaque changement une occasion d’apprendre
Après une mise en production importante, une courte revue permet de comparer le résultat au plan initial. Le changement a-t-il respecté la fenêtre prévue ? Les utilisateurs ont-ils rencontré des difficultés ? Le dispositif de restauration a-t-il fonctionné ? Les réponses alimentent la base de connaissances et améliorent les prochaines demandes.
Si un changement échoue, l’objectif n’est pas de chercher un coupable. Il s’agit de comprendre les causes : dépendance oubliée, test insuffisant, communication tardive ou indicateur d’alerte mal choisi. Une équipe qui peut parler ouvertement des échecs apprend plus vite qu’une organisation où chaque incident pousse les collaborateurs à dissimuler les problèmes.
Pour une petite DSI, les premières améliorations peuvent rester simples : un modèle de demande court, des catégories de risque claires, un calendrier partagé et une trace écrite des décisions. Les structures plus grandes peuvent ajouter des flux automatisés, des tableaux de bord et des règles de déploiement. Dans les deux cas, la priorité est la même : réduire les surprises sans ralentir inutilement les changements utiles.
Insight clé : un CAB efficace se mesure à sa capacité à faire progresser la fiabilité et la vitesse ensemble, pas à la quantité de contrôles qu’il impose.
À quoi sert vraiment un CAB ITIL ?
Le CAB réunit des expertises techniques, métier et sécurité pour évaluer les changements importants, repérer les risques et conseiller sur leur calendrier ou leurs mesures de réduction. Il aide à maintenir la continuité des services sans imposer une revue collective à chaque changement mineur.
Le CAB approuve-t-il lui-même tous les changements ?
Pas nécessairement. CAB signifie Change Advisory Board : son rôle est d’abord consultatif. Selon les règles de l’organisation, le gestionnaire du changement ou une autorité désignée prend la décision finale en s’appuyant sur les recommandations du comité.
Quelle est la différence entre CAB et ECAB ?
Le CAB examine les changements selon le calendrier habituel. L’ECAB est un groupe mobilisé pour évaluer rapidement un changement urgent, par exemple un correctif de sécurité critique, avec une documentation adaptée et une revue après intervention.
Comment éviter que le CAB ralentisse les équipes DevOps ?
Il faut préapprouver les changements standard bien définis, automatiser les contrôles répétitifs et réserver l’analyse collective aux opérations à risque ou à fort impact. Les critères doivent être documentés, mesurables et révisés à partir des incidents et des résultats observés.